分布式计算模型MapReduce补充
分布式计算模型MapReduce补充
一、准备
- 安装VMware15虚拟化软件
- 安装CentOS 7虚拟机3个
- 安装3节点的hadoop-2.6.0-cdh5.14.2集群
- windows或mac安装IDEA
- windows做好hadoop环境配置
二、主题
- MapReduce运行模式
- hadoop序列化与反序列化
- mapreduce输入格式解析
- 自定义outputformat
- shuffle数据压缩
- mr的计数器&累加器
- mr的join
三、目标
- 理解MapReduce核心思想
- 理解MapReduce编程8步
- 理解各步骤的MapReduce编程
- 掌握mapTask及reduceTask的工作机制
四、知识要点
1. mapreduce的运行模式
1. 本地模式
(1)mapreduce程序是被提交给LocalJobRunner在本地以单进程的形式运行
(2)而处理的数据及输出结果可以在本地文件系统,也可以在hdfs上
(3)怎样实现本地运行?写一个程序,不要带集群的配置文件
本质是程序的conf中是否有mapreduce.framework.name=local以及yarn.resourcemanager.hostname=local参数
(4)本地模式非常便于进行业务逻辑的debug,只要在eclipse中打断点即可
本地模式运行代码设置
configuration.set("mapreduce.framework.name","local");
configuration.set("yarn.resourcemanager.hostname","local");

TextInputFormat.addInputPath(job,new Path("file:///D:\\3、第三天\input"));

TextOutputFormat.setOutputPath(job,new Path("file:///D:\\3、第三天\\output"));
2. 集群运行模式
(1)将mapreduce程序提交给yarn集群,分发到很多的节点上并发执行
(2)处理的数据和输出结果应该位于hdfs文件系统
(3)提交集群的实现步骤:
将程序打成JAR包,然后在集群的任意一个节点上用hadoop命令启动
yarn jar hadoop_hdfs_operate-1.0-SNAPSHOT.jar com.azzhu.hdfs.demo1.JobMain
2. hadoop的序列化和反序列化
-
序列化就是把内存中的对象,转换成字节序列(或其他数据传输协议)以便于存储到磁盘(持久化)和网络传输。
-
反序列化就是将收到字节序列(或其他数据传输协议)或者是磁盘的持久化数据,转换成内存中的对象。
-
Java 的序列化(Serializable)是一个重量级序列化框架,一个对象被序列化后,会附带很多额外的信息(各种校验信息,header,继承体系…),不便于在网络中高效传输;所以,hadoop 自己开发了一套序列化机制(Writable),精简,高效。不用像 java 对象类一样传输多层的父子关系,需要哪个属性就传输哪个属性值,大大的减少网络传输的开销。
-
Writable是Hadoop的序列化格式,hadoop定义了这样一个Writable接口。 一个类要支持可序列化只需实现这个接口即可。
-
另外Writable有一个子接口是WritableComparable,writableComparable是既可实现序列化,也可以对key进行比较,我们这里可以通过自定义key实现WritableComparable来实现我们的排序功能
-
在企业开发中往往常用的基本序列化类型不能满足所有需求,比如在Hadoop框架内部传递一个bean对象,那么该对象就需要实现序列化接口。
-
具体实现bean对象序列化步骤如下7步。
(1)必须实现Writable接口
(2)反序列化时,需要反射调用空参构造函数,所以必须有空参构造
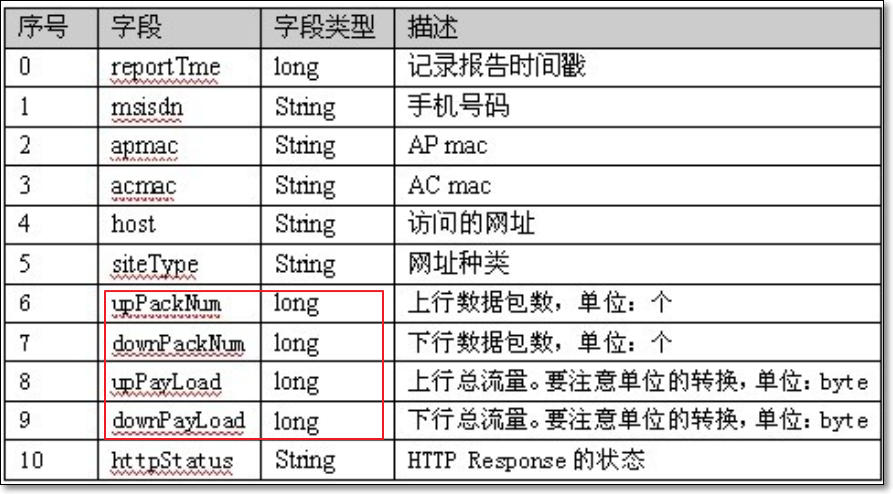
- 需求:现有用户手机上网详单数据,求取每个手机号的上行包个数之和、下行包个数之和,以及上行总流量之和、下行总流量之和
代码实现
- 定义javaBean对象:
import org.apache.hadoop.io.Writable;

import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;

//序列化与反序列化
public class FlowBean implements Writable {
    //上行包个数
    private Integer  upPackNum;
    //下行包个数
    private Integer  downPackNum;
    //上行总流量
    private Integer  upPayLoad;
    //下行总流量
    private Integer  downPayLoad;

    //反序列话的时候要用到
    public FlowBean() {
    }

    @Override
    public void write(DataOutput out) throws IOException {
        //调用序列化方法时,要用与类型匹配的write方法
        //记住序列化的顺序
        out.writeInt(upPackNum);
        out.writeInt(downPackNum);
        out.writeInt(upPayLoad);
        out.writeInt(downPayLoad);
    }

    @Override
    public void readFields(DataInput in) throws IOException {
        //发序列话的顺序要与序列化保持一直
        //使用的方法类型要匹配
        this.upPackNum = in.readInt();
        this.downPackNum = in.readInt();
        this.upPayLoad = in.readInt();
        this.downPayLoad = in.readInt();
    }

    public Integer getUpPackNum() {
        return upPackNum;
    }

    public Integer getDownPackNum() {
        return downPackNum;
    }

    public Integer getUpPayLoad() {
        return upPayLoad;
    }

    public Integer getDownPayLoad() {
        return downPayLoad;
    }

    public void setUpPackNum(Integer upPackNum) {
        this.upPackNum = upPackNum;
    }

    public void setDownPackNum(Integer downPackNum) {
        this.downPackNum = downPackNum;
    }

    public void setUpPayLoad(Integer upPayLoad) {
        this.upPayLoad = upPayLoad;
    }

    public void setDownPayLoad(Integer downPayLoad) {
        this.downPayLoad = downPayLoad;
    }

    @Override
    public String toString() {
        return "FlowBean{" +
                "upPackNum=" + upPackNum +
                ", downPackNum=" + downPackNum +
                ", upPayLoad=" + upPayLoad +
                ", downPayLoad=" + downPayLoad +
                '}';
    }
}
- 定义mapper类:
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;
import java.io.IOException;

public class FlowMapper extends Mapper<LongWritable, Text, Text, FlowBean> {
    private FlowBean flowBean;
    private Text text;

    //初始化的动作,可以写在这个方法里;一个map task在开始运行前只执行一次
    @Override
    protected void setup(Context context) throws IOException, InterruptedException {
        flowBean = new FlowBean();
        text = new Text();
    }

    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        //1363157985066    13726230503    00-FD-07-A4-72-B8:CMCC 120.196.100.82 i02.c.aliimg.com
        // 游戏娱乐    24 27 2481   24681  200
        String[] split = value.toString().split("\t");
        String phoneNum = split[1];
        //上行包个数
        String upPackNum = split[6];
        //下行包个数
        String downPackNum = split[7];
        //上行总流量
        String upPayLoad = split[8];
        //下行总流量
        String downPayLoad = split[9];

        text.set(phoneNum);

        flowBean.setUpPackNum(Integer.parseInt(upPackNum));
        flowBean.setDownPackNum(Integer.parseInt(downPackNum));
        flowBean.setUpPayLoad(Integer.parseInt(upPayLoad));
        flowBean.setDownPayLoad(Integer.parseInt(downPayLoad));

        context.write(text, flowBean);
    }
}
- 定义reducer类:
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class FlowReducer extends Reducer<Text, FlowBean, Text, Text> {

    @Override
    protected void reduce(Text key, Iterable<FlowBean> values, Context context) throws IOException, InterruptedException {
        //上行包个数
        int upPackNum = 0;
        //下行包个数
        int downPackNum = 0;
        //上行总流量
        int upPayLoad = 0;
        //下行总流量
        int downPayLoad = 0;

        for (FlowBean value : values) {
            upPackNum += value.getUpPackNum();
            downPackNum += value.getDownPackNum();
            upPayLoad += value.getUpPayLoad();
            downPayLoad += value.getDownPayLoad();
        }

        context.write(key, new Text(upPackNum + "\t" + downPackNum + "\t" + upPayLoad + "\t" + downPayLoad));
    }
}
- 定义main方法
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

public class FlowMain extends Configured implements Tool {
    /**
     * 两个参数
     * C:\Users\admin\Desktop\高级06\Hadoop\MapReduce&YARN\MR第一次\2、hadoop的序列化\数据\input
     * C:\Users\admin\Desktop\高级06\Hadoop\MapReduce&YARN\MR第一次\2、hadoop的序列化\output
     * @param args
     * @return
     * @throws Exception
     */
    @Override
    public int run(String[] args) throws Exception {
        //获取job对象
        Job job = Job.getInstance(super.getConf(), FlowMain.class.getSimpleName());
        //如果程序打包运行必须要设置这一句
        job.setJarByClass(FlowMain.class);

        job.setInputFormatClass(TextInputFormat.class);
        //TextInputFormat.addInputPath(job, new Path("file:///C:\\Users\\admin\\Desktop\\高级05\\MR第一次\\2、hadoop的序列化\\数据\\input"));
        TextInputFormat.addInputPath(job, new Path(args[0]));

        job.setMapperClass(FlowMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(FlowBean.class);

        job.setReducerClass(FlowReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(Text.class);

        job.setOutputFormatClass(TextOutputFormat.class);
        //TextOutputFormat.setOutputPath(job, new Path("file:///C:\\Users\\admin\\Desktop\\高级05\\MR第一次\\2、hadoop的序列化\\数据\\out"));
        TextOutputFormat.setOutputPath(job, new Path(args[1]));

        boolean b = job.waitForCompletion(true);
        return b ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        Configuration configuration = new Configuration();
        int run = ToolRunner.run(configuration, new FlowMain(), args);
        System.exit(run);
    }

}
3. mapreduce的InputFormat
1. InputFormat详解
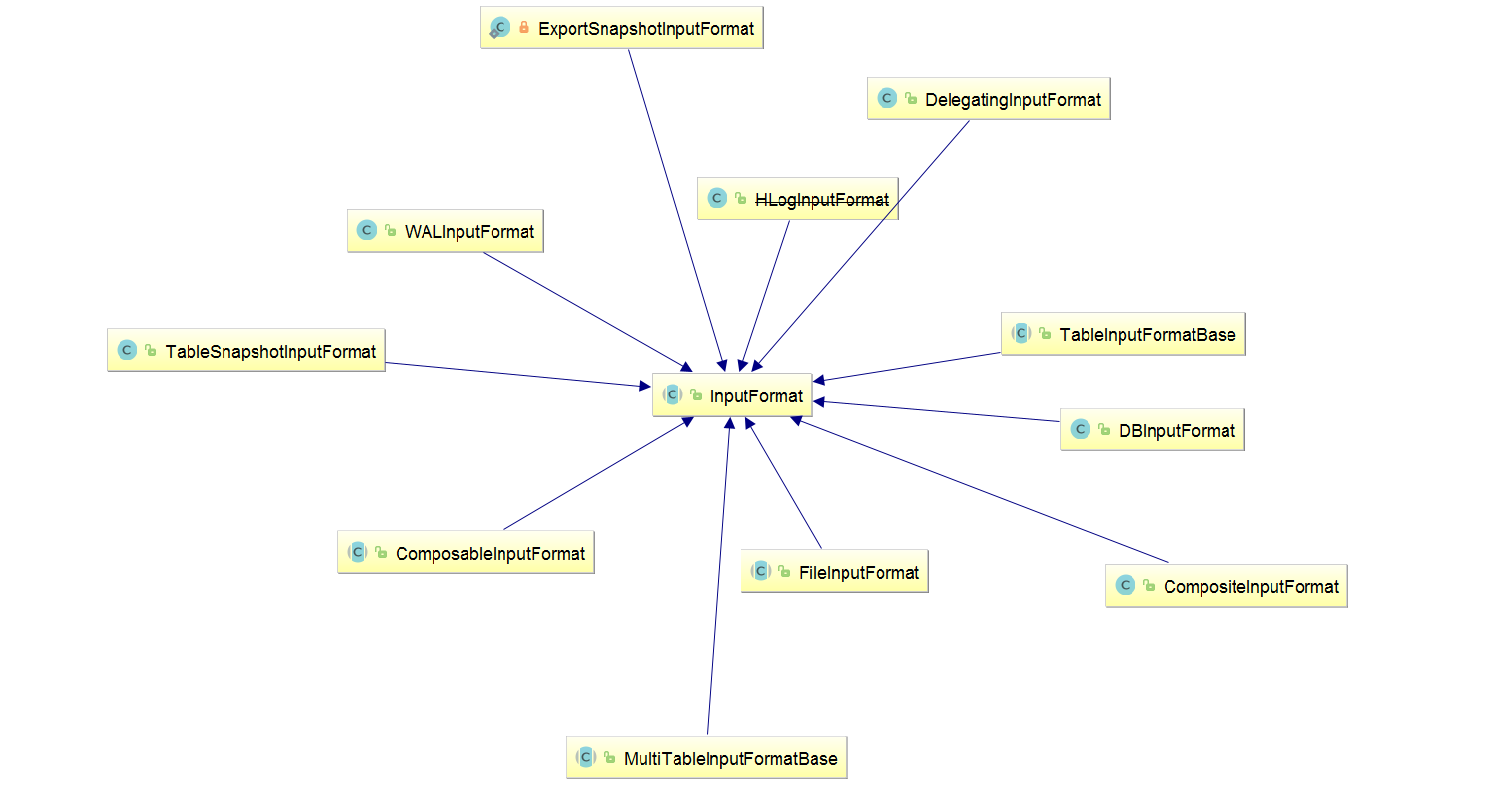
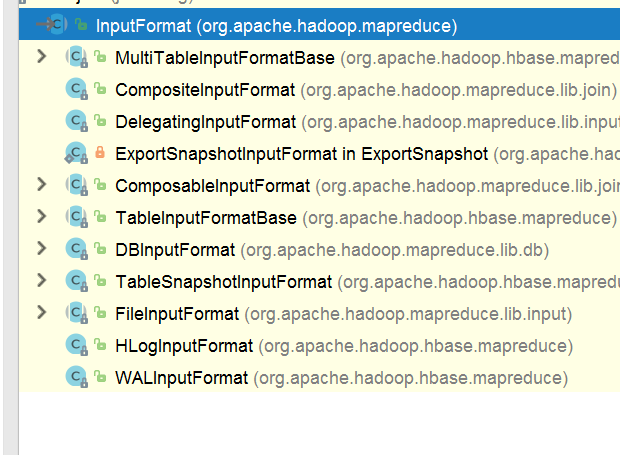
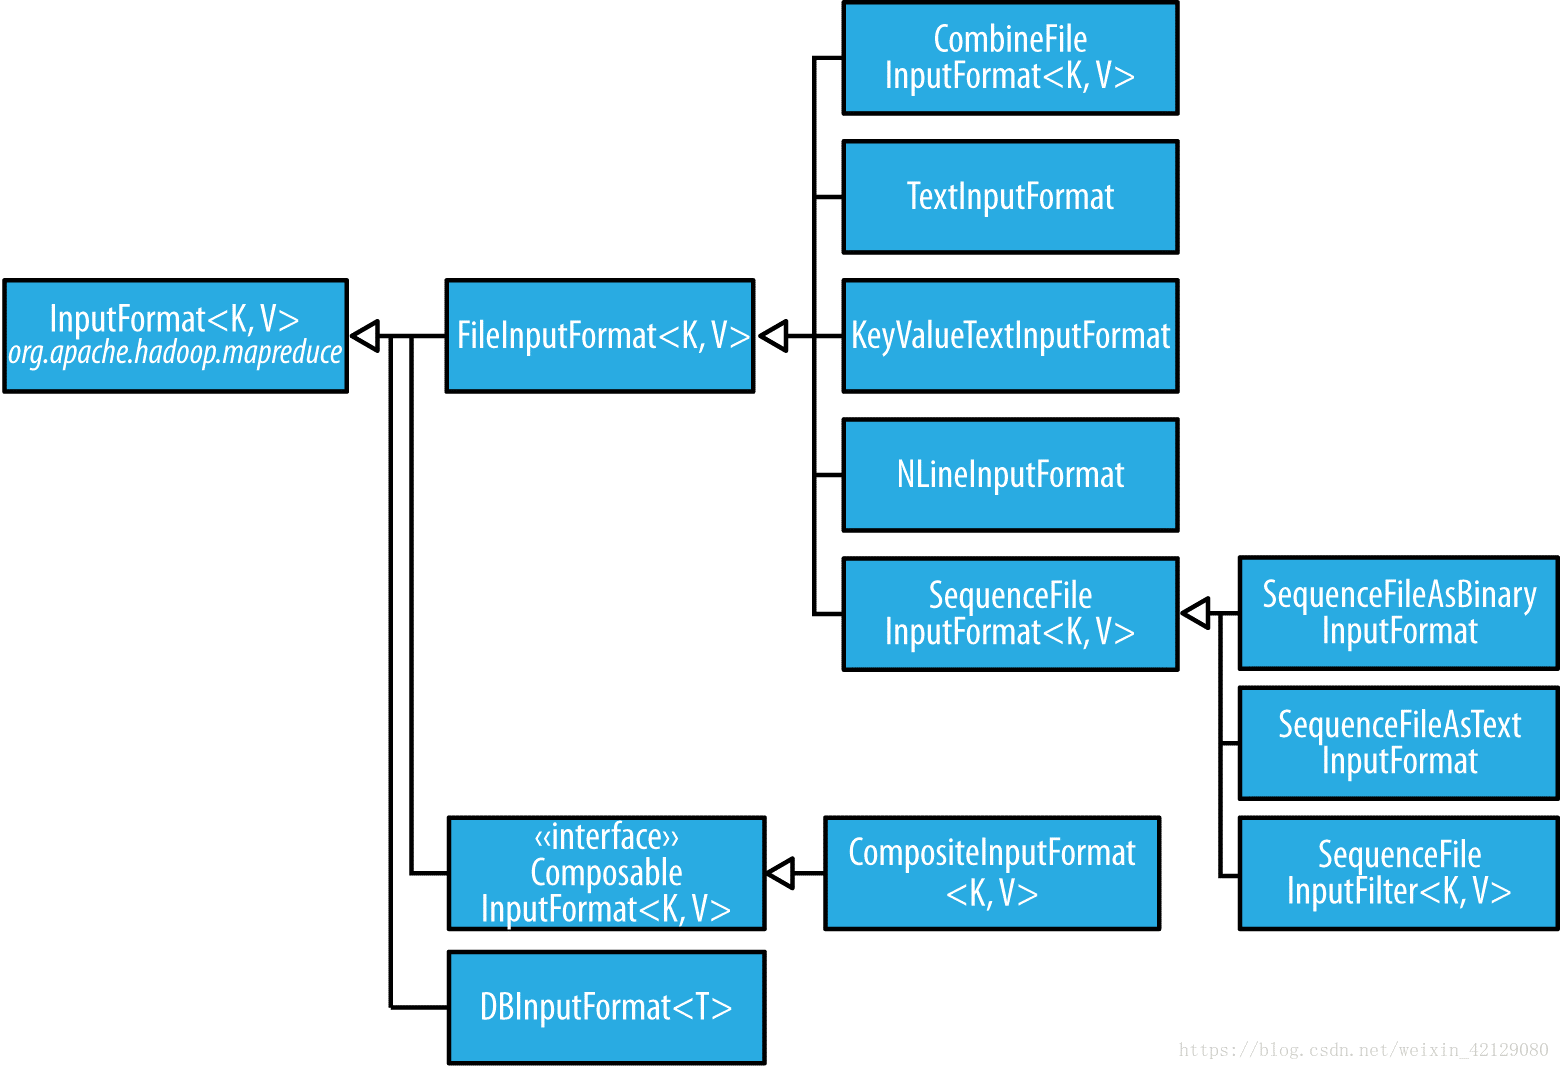
- InputFormat是mapreduce当中用于处理数据输入的一个组件,是最顶级的一个抽象父类,主要用于解决各个地方的数据源的数据输入问题。其中InputFormat的UML类图可以通过idea进行查看
2. FileInputFormat常用类介绍
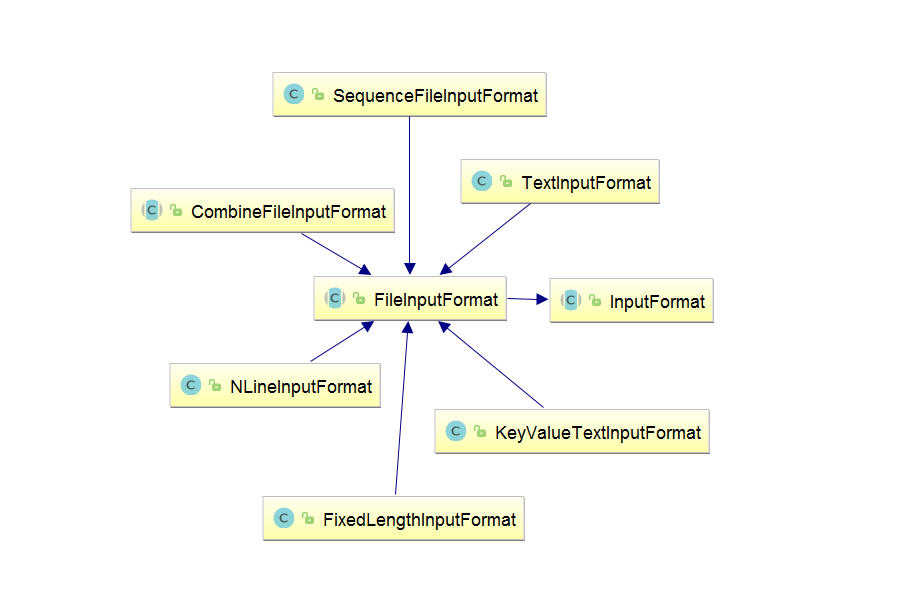
- FileInputFormat类也是InputFormat的一个子类,如果需要操作hdfs上面的文件,基本上都是通过FileInputFormat类来实现的,我们可以通过FileInputFormat来实现各种格式的文件操作,FileInputFormat的子实现类的UML类图如下
| 类名 | 主要作用 |
|---|---|
| TextInputFormat | 读取文本文件 |
| CombineFileInputFormat | 在MR当中用于合并小文件,将多个小文件合并之后只需要启动一个mapTask进行运行 |
| SequenceFileInputFormat | 处理SequenceFile这种格式的数据 |
| KeyValueTextInputFormat | 通过手动指定分隔符,将每一条数据解析成为key,value对类型 |
| NLineInputFormat | 指定数据的行数作为一个切片 |
| FixedLengthInputFormat | 从文件中读取固定宽度的二进制记录 |
3. 使用CombineTextInputFormat实现切片个数控制
- 框架默认的TextInputFormat切片机制是对任务按文件规划切片,不管文件多小,都会是一个单独的切片,都会交给一个MapTask,这样如果有大量小文件,就会产生大量的MapTask,处理效率极其低下。
1、应用场景:
CombineTextInputFormat用于小文件过多的场景,它可以将多个小文件从逻辑上规划到一个切片中,这样,多个小文件就可以交给一个MapTask处理。
2、虚拟存储切片最大值设置
CombineTextInputFormat.setMaxInputSplitSize(job, 4194304);// 4m
注意:虚拟存储切片最大值设置最好根据实际的小文件大小情况来设置具体的值。
3、切片机制
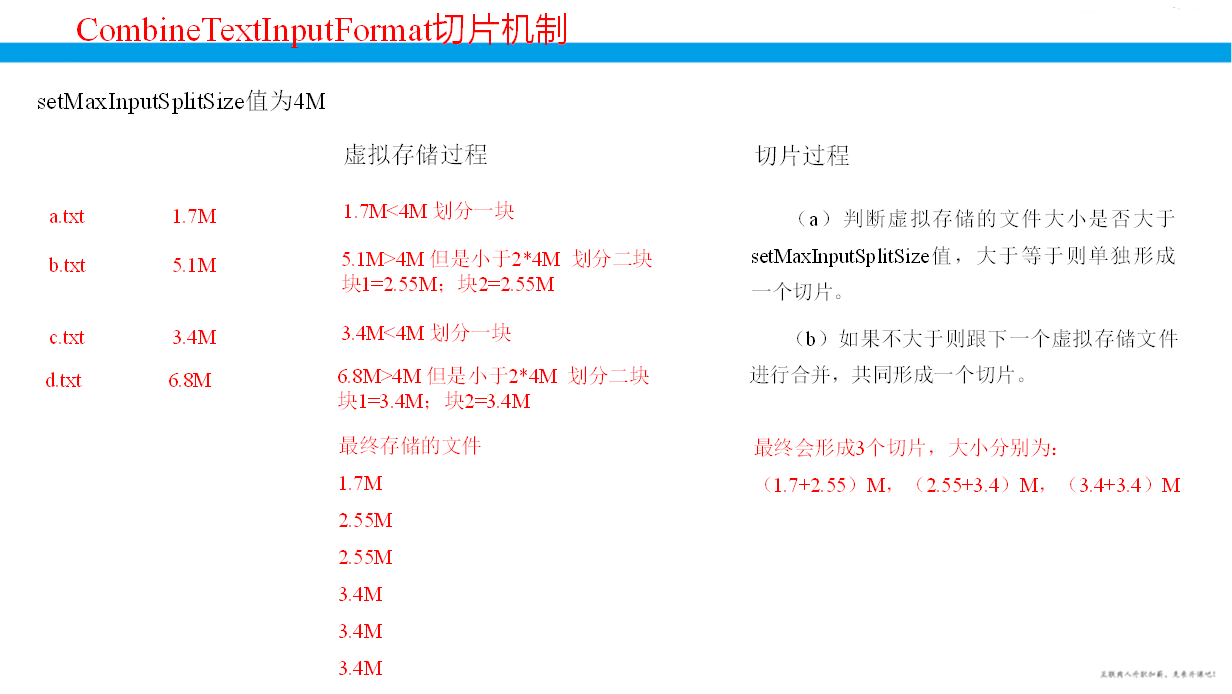
生成切片过程包括:虚拟存储过程和切片过程二部分。
- (1) 虚拟存储过程:
将输入目录下所有文件按照文件名称字典顺序排序,将每个文件的大小,依次和设置的setMaxInputSplitSize值比较;
①如果不大于设置的最大值,逻辑上划分一个块;②如果输入文件大于最大值,小于最大值的2倍,那么会将文件平分为2个虚拟存储块;③如果输入文件大于最大值的两倍,那么以最大值为单位切割出虚拟存储块;当剩余数据大小大于设置的最大值,且小于等于最大值2倍时,此时将剩余数据均分成2个虚拟存储块(防止出现太小切片)。
例如setMaxInputSplitSize值为4M,输入文件大小为8.02M,则先逻辑上分成一个4M。剩余的大小为4.02M,如果按照4M逻辑划分,就会出现0.02M的小的虚拟存储文件,所以将剩余的4.02M文件切分成(2.01M和2.01M)两个虚拟存储文件。
-
(2)切片过程:
(a)判断虚拟存储的文件大小是否大于setMaxInputSplitSize值,大于等于则单独形成一个切片。
(b)如果不大于则跟下一个虚拟存储文件进行合并;如果合并后,还不大于setMaxInputSplitSize,则继续与下一个虚拟存储文件进行合并;当合并后,大于setMaxInputSplitSize后,共同形成一个切片。
(c)测试举例:有4个小文件大小分别为1.7M、5.1M、3.4M以及6.8M这四个小文件,则虚拟存储之后形成6个文件块,大小分别为:
1.7M,(2.55M、2.55M),3.4M以及(3.4M、3.4M)
最终会形成3个切片,大小分别为:
(1.7+2.55)M,(2.55+3.4)M,(3.4+3.4)M
4. CombineTextInputFormat实战
- 在我们前面的wordCount实战案例中,更改以下代码
// job.setInputFormatClass(TextInputFormat.class);
job.setInputFormatClass(CombineTextInputFormat.class); //设置我们的输入类型为CombineTextInputFormat
//虚拟存储切片最大值设置4m  设置每个切片处理数据量为4M
CombineTextInputFormat.setMaxInputSplitSize(job, 4194304);
将我们的切片设置成为4M大小,然后重新打包运行,观察mapTask的个数
5. KeyValueTextInputFormat使用示例
- KeyValueTextInputFormat允许我们自己来定义分隔符,通过分隔符来自定义我们的key和value,参见附件当中的数据,数据之间的分隔符为@zolen@ 数据内容如下
hello@zolen@ input datas today
count@zolen@ hadoop spark
hello@zolen@ input some datas to test
- 期望输出结果如下
hello  2
count  1
- 定义mapreduce程序代码实现
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.KeyValueTextInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

import java.io.IOException;

public class KeyValueMain  {

    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
        Configuration configuration = new Configuration();
        //翻阅 KeyValueLineRecordReader 的源码,发现切割参数的配置
        configuration.set("key.value.separator.in.input.line","@zolen@");
        Job job = Job.getInstance(configuration);
        //第一步:读取文件,解析成为key,value对
        KeyValueTextInputFormat.addInputPath(job,new Path("file:///D:\\3、第三天\\2、keyValueTextInputFormat\\数据"));

        job.setInputFormatClass(KeyValueTextInputFormat.class);
        //第二步:设置mapper类
        job.setMapperClass(KeyValueMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(LongWritable.class);
        //第三步到第六步 分区,排序,规约,分组 省略
        //第七步:设置reducer类
        job.setReducerClass(KeyValueReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(LongWritable.class);
        //第八步:输出数据
        job.setOutputFormatClass(TextOutputFormat.class);
        TextOutputFormat.setOutputPath(job,new Path("file:///D:\\3、第三天\\2、keyValueTextInputFormat\\out_result"));
        boolean b = job.waitForCompletion(true);
        System.exit(0);
    }

    public static class KeyValueMapper extends Mapper<Text,Text,Text, LongWritable> {
        LongWritable outValue = new LongWritable(1);
        @Override
        protected void map(Text key, Text value, Context context) throws IOException, InterruptedException {
            context.write(key,outValue);
        }
    }

    public class KeyValueReducer extends Reducer<Text, LongWritable,Text,LongWritable> {
        @Override
        protected void reduce(Text key, Iterable<LongWritable> values, Context context) throws IOException, InterruptedException {
            long result = 0;
            for (LongWritable value : values) {
                long l = value.get();
                result += l;
            }
            context.write(key,new LongWritable(result));
        }
    }
}
6. NlineInputFormat使用示例
-
NLineInputFormat允许我们自己定义输入的行数作为一个切片数据
-
需求:读取课件当中的数据,实现自己定义多少行数据作为一个切片,并统计单词出现的次数
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.Reducer;
import org.apache.hadoop.mapreduce.lib.input.NLineInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

import java.io.IOException;

public class NLineMain {
    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
        Configuration configuration = new Configuration();
        Job job = Job.getInstance(configuration);
        job.setJarByClass(NLineMain.class);
        NLineInputFormat.setNumLinesPerSplit(job,3);
        job.setInputFormatClass(NLineInputFormat.class);
        NLineInputFormat.addInputPath(job,new Path("file:///D:\\3、NLineInputFormat\\数据"));
        //第二步:自定义mapper类
        job.setMapperClass(NLineMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(LongWritable.class);
        //第三步到第六步  分区,排序,规约,分组
        job.setReducerClass(NLineReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(LongWritable.class);
        job.setOutputFormatClass(TextOutputFormat.class);
        TextOutputFormat.setOutputPath(job,new Path("file:///D:\\3、NLineInputFormat\\数据\\out_nline"));
        job.waitForCompletion(true);
    }
    public static class NLineMapper extends Mapper<LongWritable, Text,Text,LongWritable>{
        @Override
        protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
            String[] s = value.toString().split(" ");
            for (String s1 : s) {
                context.write(new Text(s1),new LongWritable(1));
            }
        }
    }

    public static class NLineReducer extends Reducer<Text,LongWritable,Text,LongWritable>{
        @Override
        protected void reduce(Text key, Iterable<LongWritable> values, Context context) throws IOException, InterruptedException {
            long result = 0L;
            for (LongWritable value : values) {
                result +=value.get();
            }
            context.write(key,new LongWritable(result));
        }
    }
}
4. 自定义OutputFormat
1. 需求
- 现在有一些订单的评论数据,需求,将订单的好评与其他评论(中评、差评)进行区分开来,将最终的数据分开到不同的文件夹下面去,数据内容参见资料文件夹,其中数据第九个字段表示好评,中评,差评。0:好评,1:中评,2:差评
2. 分析
- 程序的关键点是要在一个mapreduce程序中根据数据的不同输出两类结果到不同目录,这类灵活的输出需求可以通过自定义outputformat来实现
3. 实现
- 实现要点:
1、 在mapreduce中访问外部资源
2、 自定义outputformat,改写其中的recordwriter,改写具体输出数据的方法write()
第一步:自定义一个outputformat
import org.apache.hadoop.fs.FSDataOutputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.RecordWriter;
import org.apache.hadoop.mapreduce.TaskAttemptContext;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import java.io.IOException;

//泛型指的是输出的k,v类型
public class MyOutputFormat extends FileOutputFormat<Text, NullWritable> {

    @Override
    public RecordWriter<Text, NullWritable> getRecordWriter(TaskAttemptContext context) throws IOException, InterruptedException {
        FileSystem fs = FileSystem.get(context.getConfiguration());
        Path goodComment = new Path("file:///C:\\1、HK\\3、ME\\2、高级0x\\1、Hadoop集群升级课件\\9、MapReduce\\MR第一次\\11、自定义outputFormat\\good\\1.txt");
        Path badComment = new Path("file:///C:\\1、HK\\3、ME\\2、高级0x\\1、Hadoop集群升级课件\\9、MapReduce\\MR第一次\\11、自定义outputFormat\\bad\\1.txt");
        FSDataOutputStream goodOutputStream = fs.create(goodComment);
        FSDataOutputStream badOutputStream = fs.create(badComment);
        return new MyRecordWriter(goodOutputStream, badOutputStream);
    }

    static class MyRecordWriter extends RecordWriter<Text, NullWritable> {
        FSDataOutputStream goodStream = null;
        FSDataOutputStream badStream = null;

        public MyRecordWriter(FSDataOutputStream goodStream, FSDataOutputStream badStream) {
            this.goodStream = goodStream;
            this.badStream = badStream;
        }

        @Override
        public void write(Text key, NullWritable value) throws IOException, InterruptedException {
            if (key.toString().split("\t")[9].equals("0")) {//好评
                goodStream.write(key.toString().getBytes());
                goodStream.write("\r\n".getBytes());
            } else {//中评或差评
                badStream.write(key.toString().getBytes());
                badStream.write("\r\n".getBytes());
            }
        }

        //释放资源
        @Override
        public void close(TaskAttemptContext context) throws IOException, InterruptedException {
            if (badStream != null) {
                badStream.close();
            }
            if (goodStream != null) {
                goodStream.close();
            }
        }
    }
}
第二步:开发mapreduce处理流程
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

import java.io.IOException;

public class MyOwnOutputFormatMain extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {
        Configuration conf = super.getConf();
        Job job = Job.getInstance(conf, MyOwnOutputFormatMain.class.getSimpleName());
        job.setJarByClass(MyOwnOutputFormatMain.class);

        job.setInputFormatClass(TextInputFormat.class);
        TextInputFormat.addInputPath(job, new Path(args[0]));

        job.setMapperClass(MyOwnMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(NullWritable.class);

        //使用默认的Reduce类的逻辑
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(NullWritable.class);

        job.setOutputFormatClass(MyOutputFormat.class);
        //设置一个输出目录,这个目录会输出一个success的成功标志的文件
        MyOutputFormat.setOutputPath(job, new Path(args[1]));

        //可以观察现象
        job.setNumReduceTasks(2);

        boolean b = job.waitForCompletion(true);
        return b ? 0 : 1;
    }

    //kout:评分等级 0, 1, 2
    public static class MyOwnMapper extends Mapper<LongWritable, Text, Text, NullWritable> {
        @Override
        protected void map(LongWritable key, Text value, Mapper.Context context) throws IOException, InterruptedException {
            //评分
            //String commentStatus = split[9];
            context.write(value, NullWritable.get());
        }
    }

    public static void main(String[] args) throws Exception {
        Configuration configuration = new Configuration();
        ToolRunner.run(configuration, new MyOwnOutputFormatMain(), args);
    }
}
5. shuffle中数据压缩
-
在shuffle阶段,可以看到数据通过大量的拷贝,从map阶段输出的数据,都要通过网络拷贝,发送到reduce阶段,这一过程中,涉及到大量的网络IO,如果数据能够进行压缩,那么数据的发送量就会少得多,那么如何配置hadoop的文件压缩呢,以及hadoop当中的文件压缩支持哪些压缩算法呢??我们接下来一一细
MapReduce的执行流程
为什么要配置压缩:
MapReduce
input
mapper
shuffle
partitioner、sort、combiner、【compress】、group
reducer
output
1、hadoop当中支持的压缩算法
文件压缩有两大好处,节约磁盘空间,加速数据在网络和磁盘上的传输
前面我们的hadoop的版本经过我们重新编译之后,我们可以看到我们的hadoop已经支持所有的压缩格式了,剩下的问题就是我们该如何选择使用这些压缩格式来对我们的MapReduce程序进行压缩
我们可以使用bin/hadoop checknative 来查看我们编译之后的hadoop支持的各种压缩,如果出现openssl为false,那么就在线安装一下依赖包
bin/hadoop checknative
yum install openssl-devel
- hadoop支持的压缩算法
| 压缩格式 | 工具 | 算法 | 文件扩展名 | 是否可切分 |
|---|---|---|---|---|
| DEFLATE | 无 | DEFLATE | .deflate | 否 |
| Gzip | gzip | DEFLATE | .gz | 否 |
| bzip2 | bzip2 | bzip2 | bz2 | 是 |
| LZO | lzop | LZO | .lzo | 否 |
| LZ4 | 无 | LZ4 | .lz4 | 否 |
| Snappy | 无 | Snappy | .snappy | 否 |
- 各种压缩算法对应使用的java类
| 压缩格式 | 对应使用的java类 |
|---|---|
| DEFLATE | org.apache.hadoop.io.compress.DeFaultCodec |
| gzip | org.apache.hadoop.io.compress.GZipCodec |
| bzip2 | org.apache.hadoop.io.compress.BZip2Codec |
| LZO | com.hadoop.compression.lzo.LzopCodec |
| LZ4 | org.apache.hadoop.io.compress.Lz4Codec |
| Snappy | org.apache.hadoop.io.compress.SnappyCodec |
- 常见的压缩速率比较
| 压缩算法 | 原始文件大小 | 压缩后的文件大小 | 压缩速度 | 解压缩速度 |
|---|---|---|---|---|
| gzip | 8.3GB | 1.8GB | 17.5MB/s | 58MB/s |
| bzip2 | 8.3GB | 1.1GB | 2.4MB/s | 9.5MB/s |
| LZO-bset | 8.3GB | 2GB | 4MB/s | 60.6MB/s |
| LZO | 8.3GB | 2.9GB | 135 MB/s | 410 MB/s |
| snappy | 8.3GB | 1.8GB | 172MB/s | 409MB/s |
常用的压缩算法主要有LZO和snappy等
如何开启我们的压缩:
方式一:在代码中进行设置压缩
- 设置我们的map阶段的压缩
Configuration configuration = new Configuration();
configuration.set("mapreduce.map.output.compress","true");
configuration.set("mapreduce.map.output.compress.codec","org.apache.hadoop.io.compress.SnappyCodec");

设置我们的reduce阶段的压缩

configuration.set("mapreduce.output.fileoutputformat.compress","true");
configuration.set("mapreduce.output.fileoutputformat.compress.type","RECORD");
configuration.set("mapreduce.output.fileoutputformat.compress.codec","org.apache.hadoop.io.compress.SnappyCodec");
方式二:修改mapred-site.xml进行MapReduce压缩
-
我们可以修改mapred-site.xml配置文件,然后重启集群,以便对所有的mapreduce任务进行压缩
-
map输出数据进行压缩
<property>
	<name>mapreduce.map.output.compress</name>
	<value>true</value>
</property>
<property>
	<name>mapreduce.map.output.compress.codec</name>
	<value>org.apache.hadoop.io.compress.SnappyCodec</value>
</property>
- reduce输出数据进行压缩
<property>
	<name>mapreduce.output.fileoutputformat.compress</name>
	<value>true</value>
</property>
<property>
	<name>mapreduce.output.fileoutputformat.compress.type</name>
	<value>RECORD</value>
</property>
<property>
	<name>mapreduce.output.fileoutputformat.compress.codec</name>
	<value>org.apache.hadoop.io.compress.SnappyCodec</value>
</property
所有节点都要修改mapred-site.xml,修改完成之后记得重启集群
使用hadoop的snappy压缩来对我们的数据进行压缩
- 这里我们通过修改代码的方式来实现数据的压缩
//map阶段输出压缩配置
Configuration configuration = new Configuration();
configuration.set("mapreduce.map.output.compress","true");
configuration.set("mapreduce.map.output.compress.codec","org.apache.hadoop.io.compress.SnappyCodec");

//reduce阶段输出压缩配置
configuration.set("mapreduce.output.fileoutputformat.compress","true");
configuration.set("mapreduce.output.fileoutputformat.compress.type","RECORD");
configuration.set("mapreduce.output.fileoutputformat.compress.codec","org.apache.hadoop.io.compress.SnappyCodec");
重新打包测试mr程序
会发现我们的MR运行之后的输出文件都变成了以.snappy的压缩文件
6. 计数器与累加器
-
计数器是收集作业统计信息的有效手段之一,用于质量控制或应用级统计。计数器还可辅助诊断系统故障。如果需要将日志信息传输到map 或reduce 任务, 更好的方法通常是看能否用一个计数器值来记录某一特定事件的发生。对于大型分布式作业而言,使用计数器更为方便。除了因为获取计数器值比输出日志更方便,还有根据计数器值统计特定事件的发生次数要比分析一堆日志文件容易得多。
-
hadoop内置计数器列表
| MapReduce任务计数器 | org.apache.hadoop.mapreduce.TaskCounter |
|---|---|
| 文件系统计数器 | org.apache.hadoop.mapreduce.FileSystemCounter |
| FileInputFormat计数器 | org.apache.hadoop.mapreduce.lib.input.FileInputFormatCounter |
| FileOutputFormat计数器 | org.apache.hadoop.mapreduce.lib.output.FileOutputFormatCounter |
| 作业计数器 | org.apache.hadoop.mapreduce.JobCounter |
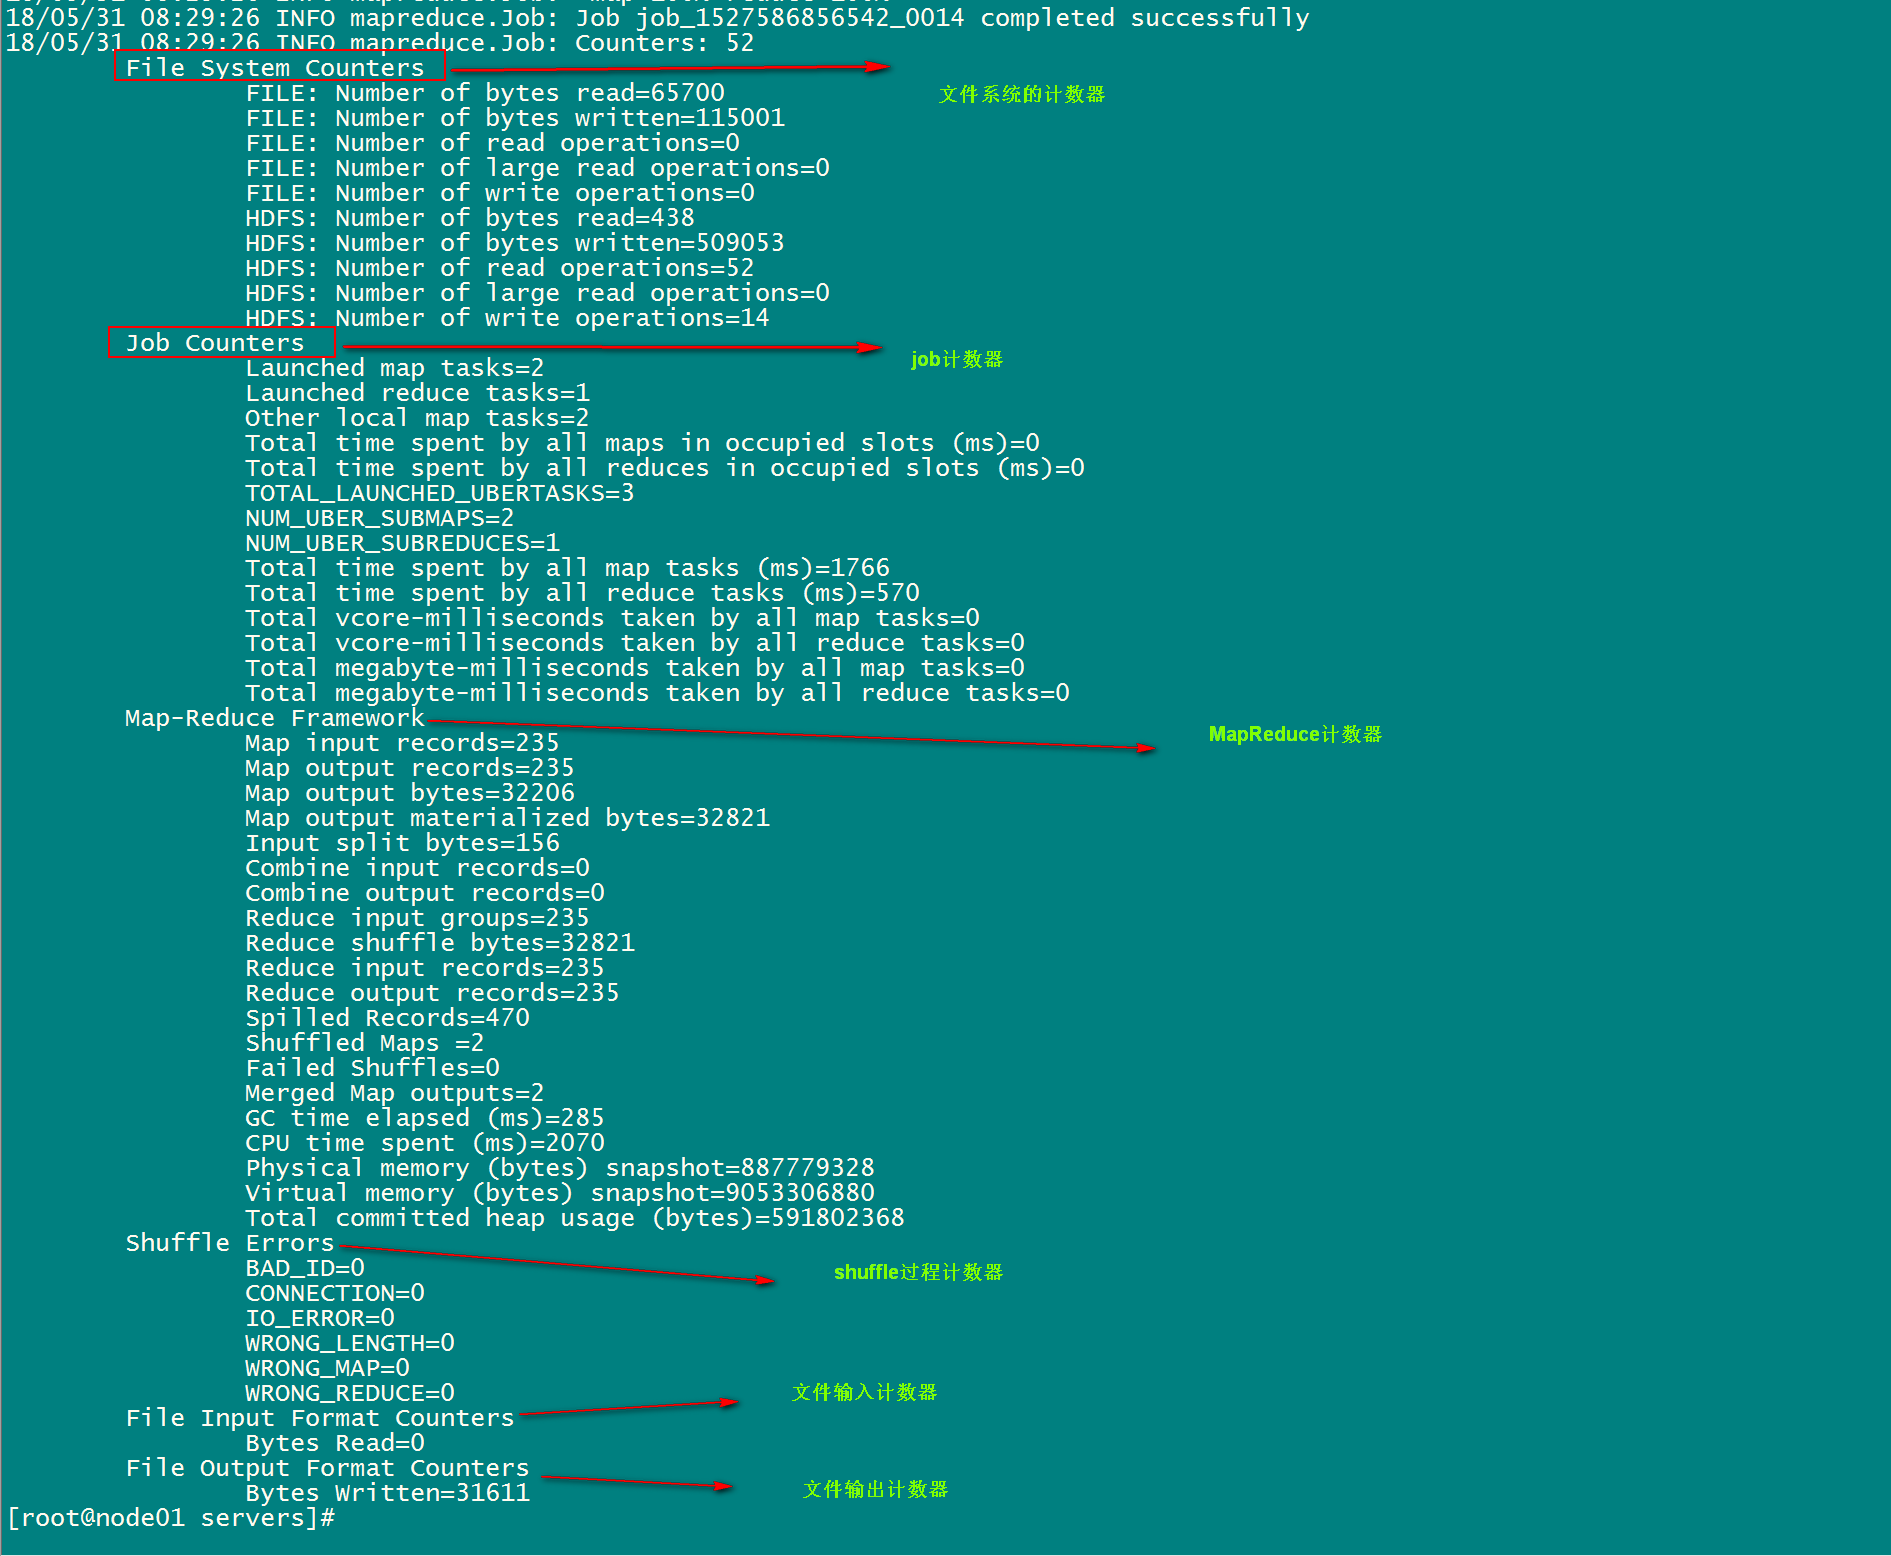
- 每次mapreduce执行完成之后,我们都会看到一些日志记录出来,其中最重要的一些日志记录如下截图
-
所有的这些都是MapReduce的计数器的功能,既然MapReduce当中有计数器的功能,我们如何实现自己的计数器???
-
需求:以上面排序以及序列化为案例,统计map接收到的数据记录条数
-
第一种方式定义计数器,通过context上下文对象可以获取我们的计数器,进行记录
-
通过context上下文对象,在map端使用计数器进行统计
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Counter;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class FlowSortMapper extends Mapper<LongWritable, Text, FlowSortBean, NullWritable> {

    private FlowSortBean flowSortBean;

    //初始化
    @Override
    protected void setup(Context context) throws IOException, InterruptedException {
        flowSortBean = new FlowSortBean();
    }

    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        //自定义我们的计数器,这里实现了统计map输入数据的条数
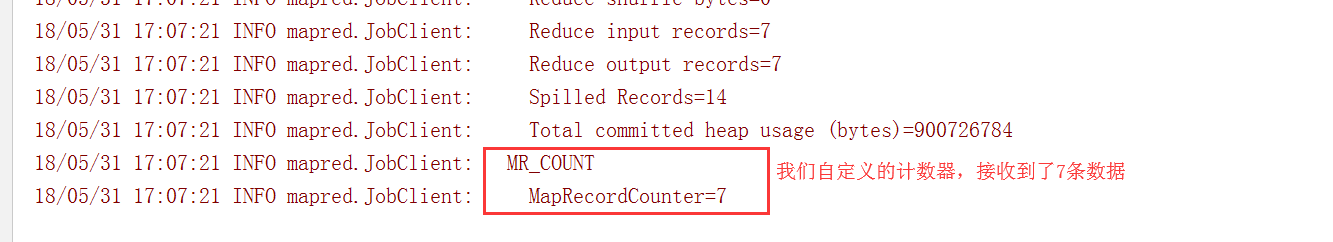
        Counter counter = context.getCounter("MR_COUNT", "MapRecordCounter");
        counter.increment(1L);

        /**
         * 手机号 上行包    下行包    上行总流量  下行总流量
         * 13480253104 3  3  180    180
         */
        String[] split = value.toString().split("\t");

        flowSortBean.setPhone(split[0]);
        flowSortBean.setUpPackNum(Integer.parseInt(split[1]));
        flowSortBean.setDownPackNum(Integer.parseInt(split[2]));
        flowSortBean.setUpPayLoad(Integer.parseInt(split[3]));
        flowSortBean.setDownPayLoad(Integer.parseInt(split[4]));

        context.write(flowSortBean, NullWritable.get());
    }
}
- 运行程序之后就可以看到我们自定义的计数器在map阶段读取了七条数据
-
第二种方式定义计数器
通过enum枚举类型来定义计数器
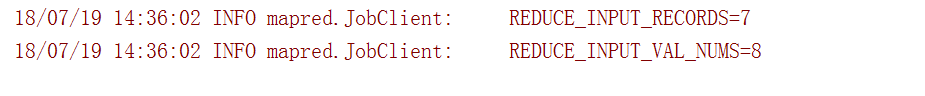
统计reduce端数据的输入的key有多少个,对应的value有多少个
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class FlowSortReducer extends Reducer<FlowSortBean, NullWritable, FlowSortBean, NullWritable> {

    public static enum Counter{
        REDUCE_INPUT_RECORDS
    }

    @Override
    protected void reduce(FlowSortBean key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException {
        context.getCounter(Counter.REDUCE_INPUT_RECORDS).increment(1L);
        //经过排序后的数据,直接输出即可
        context.write(key, NullWritable.get());
    }
}
7. mapreduce的join
1. reduce join
1、需求:
订单数据表t_order:
| id | date | pid | amount |
|---|---|---|---|
| 1001 | 20150710 | P0001 | 2 |
| 1002 | 20150710 | P0002 | 3 |
| 1002 | 20150710 | P0003 | 3 |
商品信息表t_product
| id | pname | category_id | price |
|---|---|---|---|
| P0001 | 小米5 | 1000 | 2000 |
| P0002 | 锤子T1 | 1000 | 3000 |
假如数据量巨大,两表的数据是以文件的形式存储在HDFS中,需要用mapreduce程序来实现一下SQL查询运算:
select a.id,a.date,b.name,b.category_id,b.price from t_order a join t_product b on a.pid = b.id
2、实现机制:
-
通过将关联的条件作为map输出的key,将两表满足join条件的数据并携带数据所来源的文件信息,发往同一个reduce task,在reduce中进行数据的串联
-
定义Mapper:
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.lib.input.FileSplit;

import java.io.IOException;

public class ReduceJoinMapper extends Mapper<LongWritable, Text, Text, Text> {

    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        //现在我们读取了两个文件,如何确定当前处理的这一行数据是来自哪一个文件里面的
        //方式一:通过获取文件的切片,获得文件明
        /*
        FileSplit inputSplit = (FileSplit) context.getInputSplit();//获取我们输入的文件的切片
        //获取文件名称
        String name = inputSplit.getPath().getName();
        if (name.equals("orders.txt")) {
            //订单表数据
        } else {
            //商品表数据
        }
        */

        String[] split = value.toString().split(",");

        //方式二:因为t_product表,都是以p开头,所以可以作为判断的依据
        if (value.toString().startsWith("p")) {
            //p0002,锤子T1,1000,3000
            //以商品id作为key2,相同商品的数据都会到一起去
            context.write(new Text(split[0]), value);
        } else {
            //order
            // 1001,20150710,p0001,2
            context.write(new Text(split[2]), value);
        }
    }
}
- 定义Reducer:
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;
import java.util.ArrayList;

public class ReduceJoinReducer extends Reducer<Text, Text, Text, NullWritable> {
    @Override
    protected void reduce(Text key, Iterable<Text> values, Context context) throws IOException, InterruptedException {
        //p0003 商品,订单的数据多条;保存订单信息
        ArrayList<String> orders = new ArrayList<>();
        //保存商品信息
        String product = "";

        for (Text value : values) {
            if (value.toString().startsWith("p")) {//商品
                product = value.toString();
            } else {
                orders.add(value.toString());
            }
        }

        for (String order : orders) {
            context.write(new Text(order + "\t" + product), NullWritable.get());
        }
    }
}
- 定义main方法
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

public class ReduceJoinMain extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {
        //获取job对象
        Job job = Job.getInstance(super.getConf(), ReduceJoinMain.class.getSimpleName());
        job.setJarByClass(ReduceJoinMain.class);

        //第一步:读取文件
        job.setInputFormatClass(TextInputFormat.class);
        TextInputFormat.addInputPath(job, new Path(args[0]));

        //第二步:设置自定义mapper逻辑
        job.setMapperClass(ReduceJoinMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(Text.class);

        //分区,排序,规约,分组 省略

        //第七步:设置reduce逻辑
        job.setReducerClass(ReduceJoinReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(NullWritable.class);

        //第八步:设置输出数据路径
        job.setOutputFormatClass(TextOutputFormat.class);
        TextOutputFormat.setOutputPath(job, new Path(args[1]));

        boolean b = job.waitForCompletion(true);
        return b ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        int run = ToolRunner.run(new Configuration(), new ReduceJoinMain(), args);
        System.exit(run);
    }
}
2. map join
1、原理阐述
-
适用于关联表中有小表的情形;
-
可以将小表分发到所有的map节点,这样,map节点就可以在本地对自己所读到的大表数据进行join并输出最终结果,可以大大提高join操作的并发度,加快处理速度
2、实现示例
-
先在mapper类中预先定义好小表,进行join
-
引入实际场景中的解决方案:一次加载数据库或者用
-
定义mapper类:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataInputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.URI;
import java.util.HashMap;
import java.util.Map;

public class MapJoinMapper extends Mapper<LongWritable, Text, Text, NullWritable> {
    //用于保存商品表的数据;productMap中的key是商品id,value是与key对应的表记录
    private Map<String, String> productMap;

    /**
     * 初始化方法,只在程序启动调用一次
     *
     * @param context
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    protected void setup(Context context) throws IOException, InterruptedException {

        productMap = new HashMap<String, String>();

        Configuration configuration = context.getConfiguration();

        //获取到所有的缓存文件
        //方式一
        URI[] cacheFiles = Job.getInstance(context.getConfiguration()).getCacheFiles();
        //方式二:deprecated
        //URI[] cacheFiles = DistributedCache.getCacheFiles(configuration);

        //现在只有一个缓存文件放进了分布式缓存中
        URI cacheFile = cacheFiles[0];

        //获取FileSystem
        FileSystem fileSystem = FileSystem.get(cacheFile, configuration);
        //读取文件,获取到输入流。这里面装的都是商品表的数据
        FSDataInputStream fsDataInputStream = fileSystem.open(new Path(cacheFile));

        /**
         * 商品表数据如下:
         * p0001,xiaomi,1000,2
         * p0002,appale,1000,3
         * p0003,samsung,1000,4
         */
        //获取到BufferedReader之后,可以一行一行的读取数据
        BufferedReader bufferedReader = new BufferedReader(new InputStreamReader(fsDataInputStream));
        String line = null;
        //每次循环,获得表的一行数据
        while ((line = bufferedReader.readLine()) != null) {
            String[] split = line.split(",");
            productMap.put(split[0], line);
        }
    }

    /**
     * @param key
     * @param value   订单表的记录,如1001,20150710,p0001,2
     * @param context
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        String[] split = value.toString().split(",");
        //获取订单表的商品id
        String pid = split[2];

        //获取商品表的数据
        String pdtsLine = productMap.get(pid);

        context.write(new Text(value.toString() + "\t" + pdtsLine), NullWritable.get());
    }
}
- 定义main方法:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.filecache.DistributedCache;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

import java.net.URI;

/**
 * 需求:同reduce join
 * 实现:select a.id, a.date, b.name, b.category_id, b.price
 * from t_order a
 * join t_product b
 * on a.pid = b.id
 */
public class MapJoinMain extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {
        //分布式缓存的hdfs路径
        URI uri = new URI("hdfs://node01:8020/cache/pdts.txt");

        //本地路径:需要用一下形式file:///C:/1、HK/.../pdts.txt   ;需要指定到具体的文件;如果是使用file:///c:\\1、HK\\3、ME...不符合语法会报错
        //URI uri = new URI("file:///C:/1、HK/3、ME/2、高级0x/1、Hadoop集群升级课件/9、MapReduce/MR第一次/12、join操作/map端join/cache/pdts.txt");
        Configuration configuration = super.getConf();
        //添加缓存文件 方式二:deprecated
        //DistributedCache.addCacheFile(uri, configuration);

        //获取job对象
        Job job = Job.getInstance(configuration, MapJoinMain.class.getSimpleName());
        //添加缓存文件:方式一
        job.addCacheFile(uri);
        job.setJarByClass(MapJoinMain.class);

        //读取文件,解析成为key,value对
        job.setInputFormatClass(TextInputFormat.class);
        TextInputFormat.addInputPath(job, new Path(args[0]));

        job.setMapperClass(MapJoinMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(NullWritable.class);

        //没有reducer逻辑,不用设置了
        job.setOutputFormatClass(TextOutputFormat.class);
        TextOutputFormat.setOutputPath(job, new Path(args[1]));

        job.setNumReduceTasks(2);

        boolean b = job.waitForCompletion(true);
        return b ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        int run = ToolRunner.run(new Configuration(), new MapJoinMain(), args);
        System.exit(run);
    }
}