分布式计算模型MapReduce
分布式计算模型MapReduce
一、准备
- 安装VMware15虚拟化软件
- 安装CentOS 7虚拟机3个
- 安装3节点的hadoop-2.6.0-cdh5.14.2集群
- windows或mac安装IDEA
- windows做好hadoop环境配置
二、主题
- MapReduce核心思想
- MapReduce编程
三、目标
- 理解MapReduce核心思想
- 理解MapReduce编程8步
- 理解各步骤的MapReduce编程
- 掌握mapTask及reduceTask的工作机制
四、知识要点
1. mapreduce的定义
-
MapReduce是一个分布式运算程序的编程框架,是用户开发“基于Hadoop的数据分析应用”的核心框架。
-
MapReduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个Hadoop集群上。
2. mapreduce的核心思想.
-
MapReduce思想在生活中处处可见。或多或少都曾接触过这种思想。MapReduce的思想核心是“分而治之”,适用于大量复杂的任务处理场景(大规模数据处理场景)。即使是发布过论文实现分布式计算的谷歌也只是实现了这种思想,而不是自己原创。
-
Map负责“分”,即把复杂的任务分解为若干个“简单的任务”来并行处理。可以进行拆分的前提是这些小任务可以并行计算,彼此间几乎没有依赖关系。
-
Reduce负责“合”,即对map阶段的结果进行全局汇总。
-
这两个阶段合起来正是MapReduce思想的体现。
-
还有一个比较形象的语言解释MapReduce:
-
例子一:我们要数图书馆中的所有书。你数1号书架,我数2号书架。这就是“Map”。我们人越多,数书就越快。
-
现在我们到一起,把所有人的统计数加在一起。这就是“Reduce”。
-
例子二:电影黑客帝国当中,特工”(Agents),Smith(史密斯)对付救世主Neo打不过怎么办?一个人打不过,就复制十个出来,十个不行就复制一百个
-
3. MapReduce编程模型
-
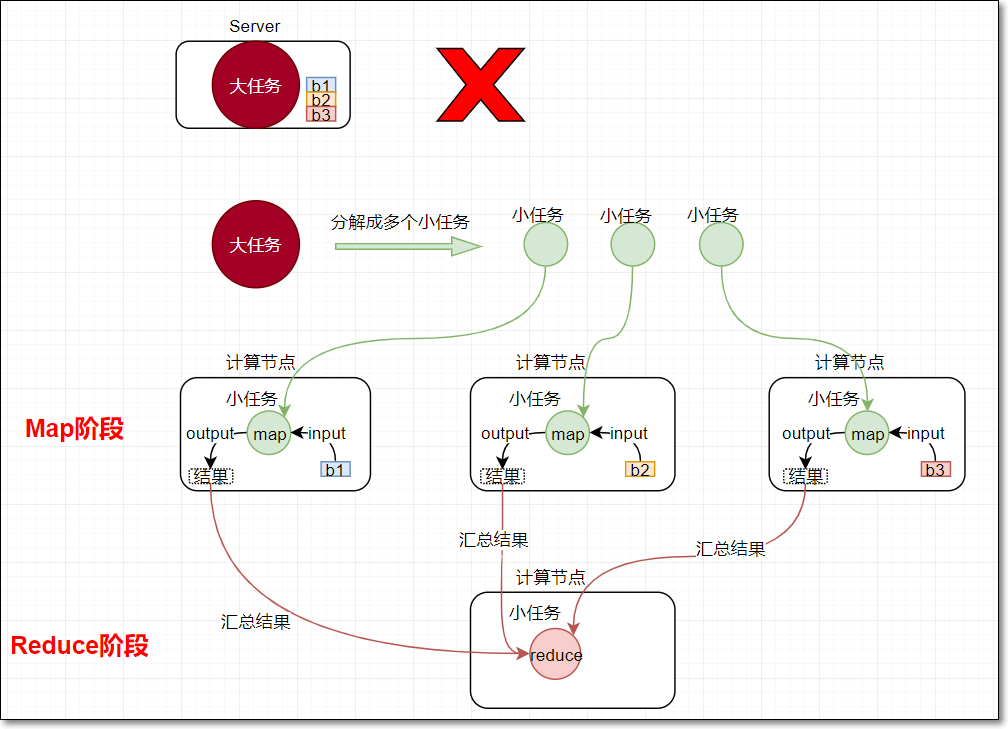
MapReduce是采用一种分而治之的思想设计出来的分布式计算框架
-
那什么是分而治之呢?
- 比如一复杂、计算量大、耗时长的的任务,暂且称为“大任务”;
- 此时使用单台服务器无法计算或较短时间内计算出结果时,可将此大任务切分成一个个小的任务,小任务分别在不同的服务器上并行的执行;
- 最终再汇总每个小任务的结果
-
MapReduce由两个阶段组 成:
- Map阶段(切分成一个个小的任务)
- Reduce阶段(汇总小任务的结果)
1. Map阶段
-
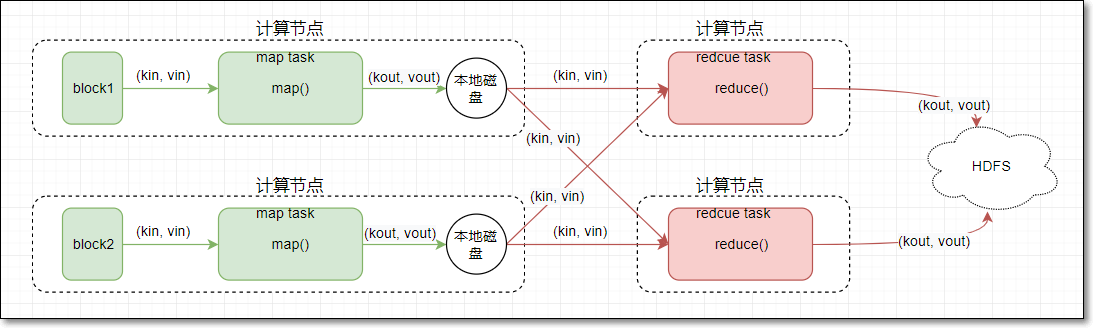
map阶段有一个关键的map()函数;
-
此函数的输入是键值对
-
输出是一系列键值对,输出写入本地磁盘。
2. Reduce阶段
-
reduce阶段有一个关键的函数reduce()函数
-
此函数的输入也是键值对(即map的输出(kv对))
-
输出也是一系列键值对,结果最终写入HDFS
3. Map&Reduce
4. mapreduce编程指导思想(八个步骤背下来)
-
mapReduce编程模型的总结:
-
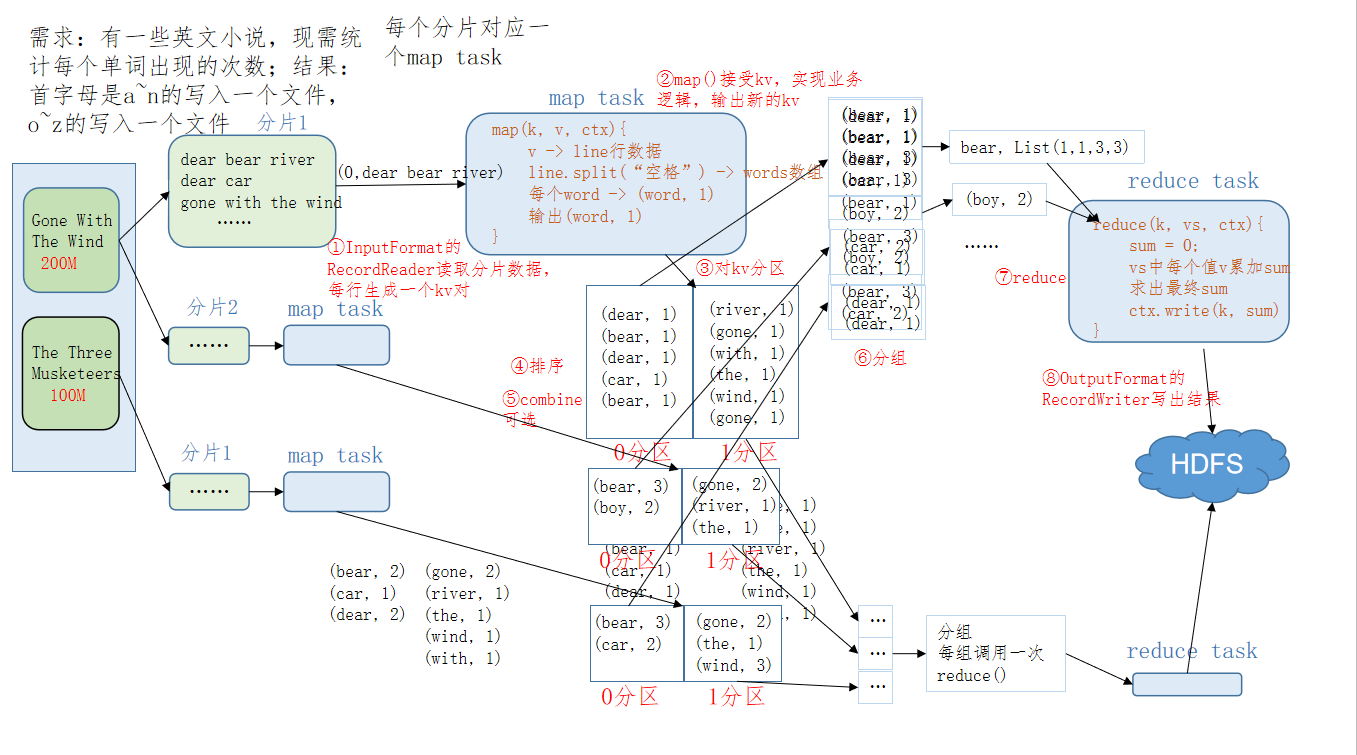
MapReduce的开发一共有八个步骤其中map阶段分为2个步骤,shuffle阶段4个步骤,reduce阶段分为2个步骤
1. Map阶段2个步骤
-
第一步:设置inputFormat类,将我们的数据切分成key,value对,输入到第二步
-
第二步:自定义map逻辑,处理我们第一步的输入数据,然后转换成新的key,value对进行输出
2. shuffle阶段4个步骤
-
第三步:对输出的key,value对进行分区。(相同key的数据属于同一分区)
-
第四步:对不同分区的数据按照相同的key进行排序
-
第五步:对分组后的数据进行规约(combine操作),降低数据的网络拷贝(可选步骤)
-
第六步:对排序后的数据进行分组,分组的过程中,将相同key的value放到一个集合当中(每组数据调用一次reduce方法)
3. reduce阶段2个步骤
-
第七步:对多个map的任务进行合并,排序,写reduce函数自己的逻辑,对输入的key,value对进行处理,转换成新的key,value对进行输出
-
第八步:设置outputformat将输出的key,value对数据进行保存到文件中
5. hadoop当中常用的数据类型
-
hadoop没有沿用java当中基本的数据类型,而是自己进行封装了一套数据类型,其自己封装的类型与java的类型对应如下
-
下表常用的数据类型对应的Hadoop数据序列化类型
| Java类型 | Hadoop Writable类型 |
|---|---|
| Boolean | BooleanWritable |
| Byte | ByteWritable |
| Int | IntWritable |
| Float | FloatWritable |
| Long | LongWritable |
| Double | DoubleWritable |
| String | Text |
| Map | MapWritable |
| Array | ArrayWritable |
| byte[] | BytesWritable |
6. mapreduce编程入门之单词统计
7. mapreduce编程入门案例之单词计数统计实现
- 需求:现有数据格式如下,每一行数据之间都是使用逗号进行分割,求取每个单词出现的次数
hello,hello
world,world
hadoop,hadoop
hello,world
hello,flume
hadoop,hive
hive,kafka
flume,storm
hive,oozie
第一步:创建maven工程并导入以下jar包
-
cdh版本的软件jar包下载参见以下这两个文档链接
-
CDH 5 Maven Repository
https://docs.cloudera.com/documentation/enterprise/release-notes/topics/cdh_vd_cdh5_maven_repo.html
-
Maven Artifacts for CDH 5.14.x Releases
	<repositories>
        <repository>
            <id>cloudera</id>
            <url>https://repository.cloudera.com/artifactory/cloudera-repos/</url>
        </repository>
    </repositories>
    <dependencies>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-client</artifactId>
            <version>2.6.0-mr1-cdh5.14.2</version>
        </dependency>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-common</artifactId>
            <version>2.6.0-cdh5.14.2</version>
        </dependency>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-hdfs</artifactId>
            <version>2.6.0-cdh5.14.2</version>
        </dependency>

        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-mapreduce-client-core</artifactId>
            <version>2.6.0-cdh5.14.2</version>
        </dependency>
        <!-- https://mvnrepository.com/artifact/junit/junit -->
        <dependency>
            <groupId>junit</groupId>
            <artifactId>junit</artifactId>
            <version>4.11</version>
            <scope>test</scope>
        </dependency>
        <dependency>
            <groupId>org.testng</groupId>
            <artifactId>testng</artifactId>
            <version>RELEASE</version>
            <scope>test</scope>
        </dependency>
    </dependencies>
    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.0</version>
                <configuration>
                    <source>1.8</source>
                    <target>1.8</target>
                    <encoding>UTF-8</encoding>
                    <!--   <verbal>true</verbal>-->
                </configuration>
            </plugin>

            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-shade-plugin</artifactId>
                <version>2.4.3</version>
                <executions>
                    <execution>
                        <phase>package</phase>
                        <goals>
                            <goal>shade</goal>
                        </goals>
                        <configuration>
                            <minimizeJar>true</minimizeJar>
                        </configuration>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>
第二步:定义mapper类
import org.apache.hadoop.io.IntWritable;
 import org.apache.hadoop.io.LongWritable;
 import org.apache.hadoop.io.Text;
 import org.apache.hadoop.mapreduce.Mapper;
 import java.io.IOException;

 /**
  * 自定义mapper类需要继承Mapper,有四个泛型,
  * keyin: k1   行偏移量 Long
  * valuein: v1   一行文本内容   String
  * keyout: k2   每一个单词   String
  * valueout : v2   1         int
  * 在hadoop当中没有沿用Java的一些基本类型,使用自己封装了一套基本类型
  * long ==>LongWritable
  * String ==> Text
  * int ==> IntWritable
  *
  */
 public class MyMapper extends Mapper<LongWritable,Text,Text,IntWritable> {
    /**
      * 继承mapper之后,覆写map方法,每次读取一行数据,都会来调用一下map方法
      * @param key:对应k1
      * @param value:对应v1
      * @param context 上下文对象。承上启下,承接上面步骤发过来的数据,通过context将数据发送到下面的步骤里面去
      * @throws IOException
      * @throws InterruptedException
      * k1   v1
      * 0;hello,world
      *
      * k2 v2
      * hello 1
      * world   1
      */
    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        //获取我们的一行数据
        String line = value.toString();
        String[] split = line.split(",");
        Text text = new Text();
        IntWritable intWritable = new IntWritable(1);
        for (String word : split) {
            //将每个单词出现都记做1次
            //key2 Text类型
            //v2 IntWritable类型
            text.set(word);
            //将我们的key2 v2写出去到下游
            context.write(text,intWritable);
        }
    }
 }
第三步:定义reducer类
import org.apache.hadoop.io.IntWritable;
 import org.apache.hadoop.io.Text;
 import org.apache.hadoop.mapreduce.Reducer;

 import java.io.IOException;

 public class MyReducer extends Reducer<Text,IntWritable,Text,IntWritable> {
    //第三步:分区   相同key的数据发送到同一个reduce里面去,相同key合并,value形成一个集合
    /**
      * 继承Reducer类之后,覆写reduce方法
      * @param key
      * @param values
      * @param context
      * @throws IOException
      * @throws InterruptedException
      */
    @Override
    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
        int result = 0;
        for (IntWritable value : values) {
            //将我们的结果进行累加
            result += value.get();
        }
        //继续输出我们的数据
        IntWritable intWritable = new IntWritable(result);
        //将我们的数据输出
        context.write(key,intWritable);
    }
 }
第四步:组装main程序
import org.apache.hadoop.conf.Configuration;
 import org.apache.hadoop.conf.Configured;
 import org.apache.hadoop.fs.Path;
 import org.apache.hadoop.io.IntWritable;
 import org.apache.hadoop.io.Text;
 import org.apache.hadoop.mapreduce.Job;
 import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
 import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
 import org.apache.hadoop.util.Tool;
 import org.apache.hadoop.util.ToolRunner;

 /*
 这个类作为mr程序的入口类,这里面写main方法
  */
 public class WordCount extends Configured implements Tool{
    /**
      * 实现Tool接口之后,需要实现一个run方法,
      * 这个run方法用于组装我们的程序的逻辑,其实就是组装八个步骤
      * @param args
      * @return
      * @throws Exception
      */
    @Override
    public int run(String[] args) throws Exception {
        //获取Job对象,组装我们的八个步骤,每一个步骤都是一个class类
        Configuration conf = super.getConf();
        Job job = Job.getInstance(conf, "mrdemo1");

        //实际工作当中,程序运行完成之后一般都是打包到集群上面去运行,打成一个jar包
        //如果要打包到集群上面去运行,必须添加以下设置
        job.setJarByClass(WordCount.class);

        //第一步:读取文件,解析成key,value对,k1:行偏移量 v1:一行文本内容
        job.setInputFormatClass(TextInputFormat.class);
        //指定我们去哪一个路径读取文件
        TextInputFormat.addInputPath(job,new Path("file:///D:\\input"));
        //第二步:自定义map逻辑,接受k1   v1 转换成为新的k2   v2输出
        job.setMapperClass(MyMapper.class);
        //设置map阶段输出的key,value的类型,其实就是k2 v2的类型
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);
        //第三步到六步:分区,排序,规约,分组都省略
        //第七步:自定义reduce逻辑
        job.setReducerClass(MyReducer.class);
        //设置key3 value3的类型
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        //第八步:输出k3 v3 进行保存
        job.setOutputFormatClass(TextOutputFormat.class);
        //一定要注意,输出路径是需要不存在的,如果存在就报错
        TextOutputFormat.setOutputPath(job,new Path("file:///D:\\out_result"));
        //提交job任务
        boolean b = job.waitForCompletion(true);
        return b?0:1;
        /***
          * 第一步:读取文件,解析成key,value对,k1   v1
          * 第二步:自定义map逻辑,接受k1   v1 转换成为新的k2   v2输出
          * 第三步:分区。相同key的数据发送到同一个reduce里面去,key合并,value形成一个集合
          * 第四步:排序   对key2进行排序。字典顺序排序
          * 第五步:规约 combiner过程 调优步骤 可选
          * 第六步:分组
          * 第七步:自定义reduce逻辑接受k2   v2 转换成为新的k3   v3输出
          * 第八步:输出k3 v3 进行保存
          *
          *
          */
    }
    /*
    作为程序的入口类
      */
    public static void main(String[] args) throws Exception {
        Configuration configuration = new Configuration();
        configuration.set("hello","world");
        //提交run方法之后,得到一个程序的退出状态码
        int run = ToolRunner.run(configuration, new WordCount(), args);
        //根据我们 程序的退出状态码,退出整个进程
        System.exit(run);
    }
 }
8. Map Task数量及切片机制
1. MapTask个数
-
在运行我们的MapReduce程序的时候,我们可以清晰的看到会有多个mapTask的运行,那么maptask的个数究竟与什么有关,是不是maptask越多越好,或者说是不是maptask的个数越少越好呢???我们可以通过MapReduce的源码进行查看mapTask的个数究竟是如何决定的
-
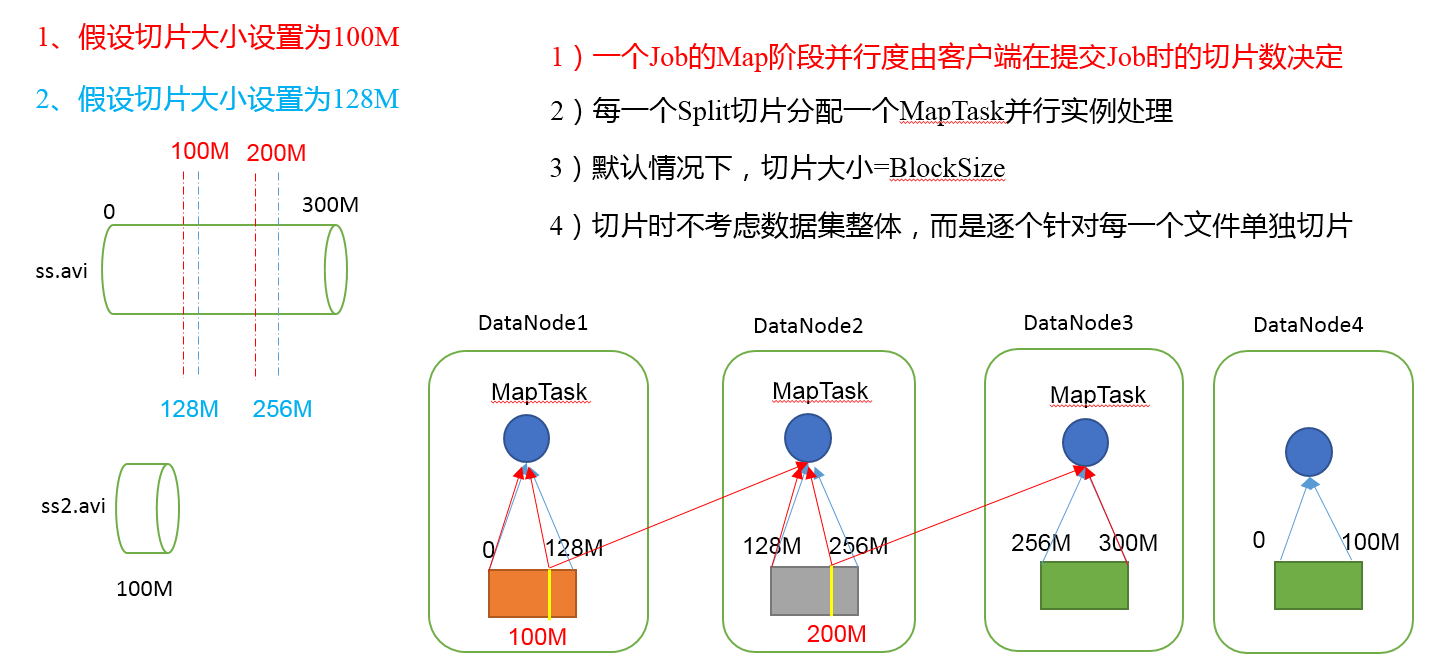
在MapReduce当中,每个mapTask处理一个切片split的数据量,注意切片与block块的概念很像,但是block块是HDFS当中存储数据的单位,切片split是MapReduce当中每个MapTask处理数据量的单位。
-
MapTask并行度决定机制
-
数据块:Block是HDFS物理上把数据分成一块一块。
-
数据切片:数据切片只是在逻辑上对输入进行分片,并不会在磁盘上将其切分成片进行存储。
-
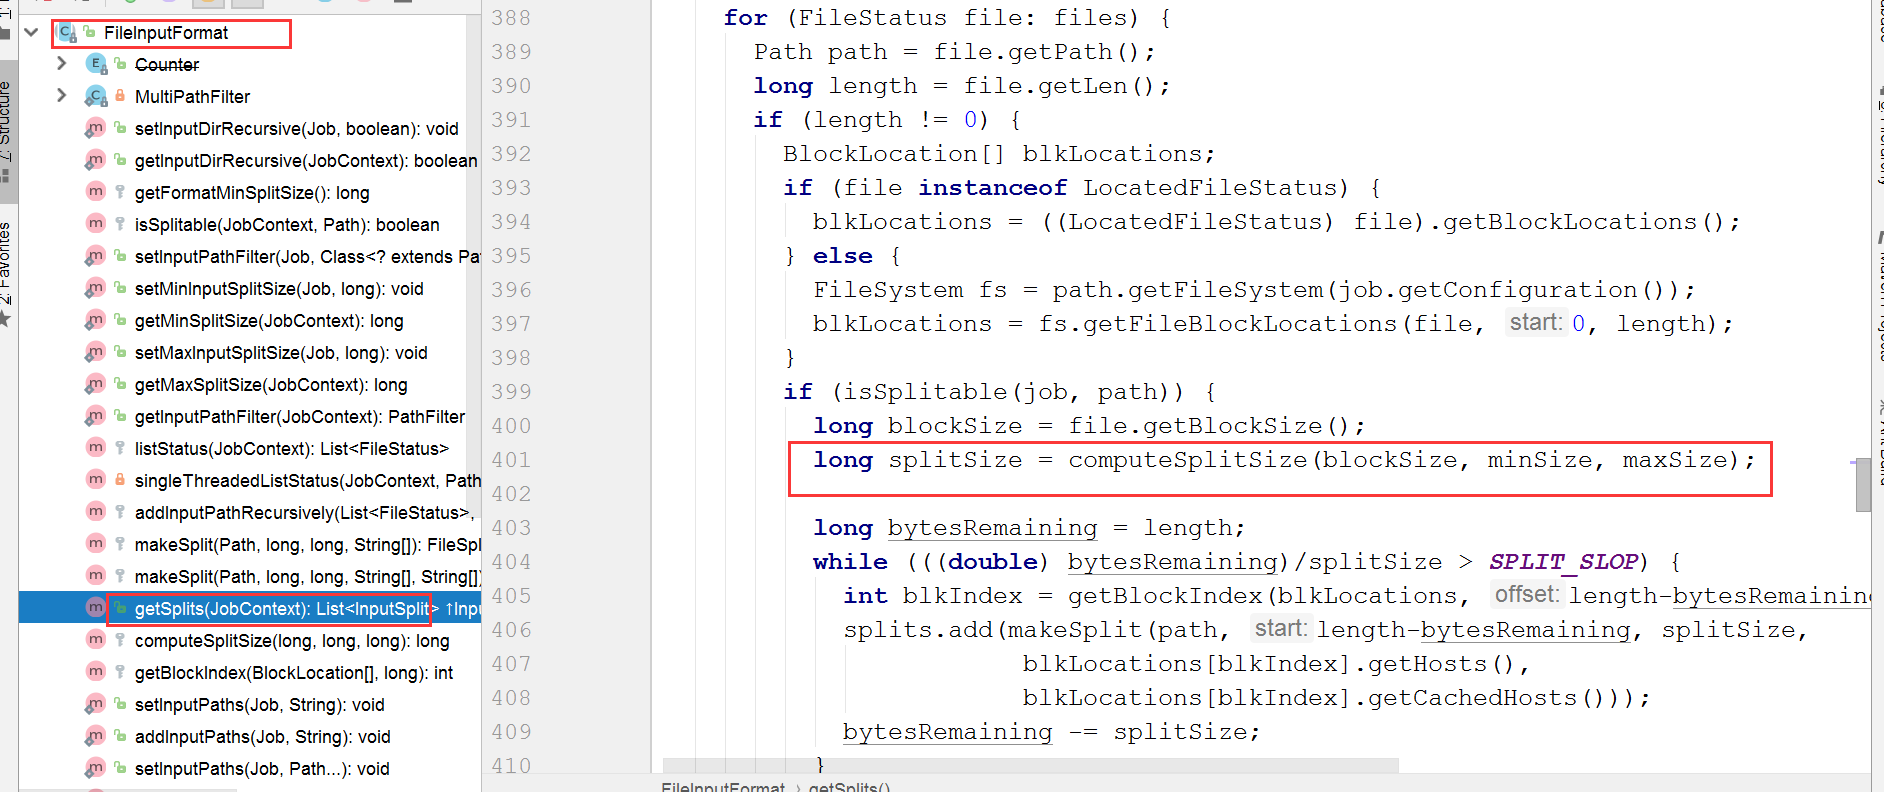
查看FileInputFormat的源码,里面getSplits的方法便是获取所有的切片,其中有个方法便是获取切片大小
- 切片大小的计算公式:
Math.max(minSize, Math.min(maxSize, blockSize));
mapreduce.input.fileinputformat.split.minsize=1 默认值为1
mapreduce.input.fileinputformat.split.maxsize= Long.MAXValue 默认值Long.MAXValue
blockSize为128M
-
由以上计算公式可以推算出split切片的大小刚好与block块相等
-
那么hdfs上面如果有以下两个文件,文件大小分别为300M和10M,那么会启动多少个MapTask???
1、输入文件两个
file1.txt    300M
file2.txt    10M
2、经过FileInputFormat的切片机制运算后,形成的切片信息如下:
file1.txt.split1-- 0~128
file1.txt.split2-- 128~256
file1.txt.split3-- 256~300
file2.txt.split1-- 0~10M
一共就会有四个切片,与我们block块的个数刚好相等
- 如果有1000个小文件,每个小文件是1kb-100MB之间,那么我们启动1000个MapTask是否合适,该如何合理的控制MapTask的个数???
2. 如何控制mapTask的个数
-
如果需要控制maptask的个数,我们只需要调整maxSize和minsize这两个值,那么切片的大小就会改变,切片大小改变之后,mapTask的个数就会改变
-
maxsize(切片最大值):参数如果调得比blockSize小,则会让切片变小,而且就等于配置的这个参数的值。
-
minsize(切片最小值):参数调的比blockSize大,则可以让切片变得比blockSize还大。
9. 自定义InputFormat
-
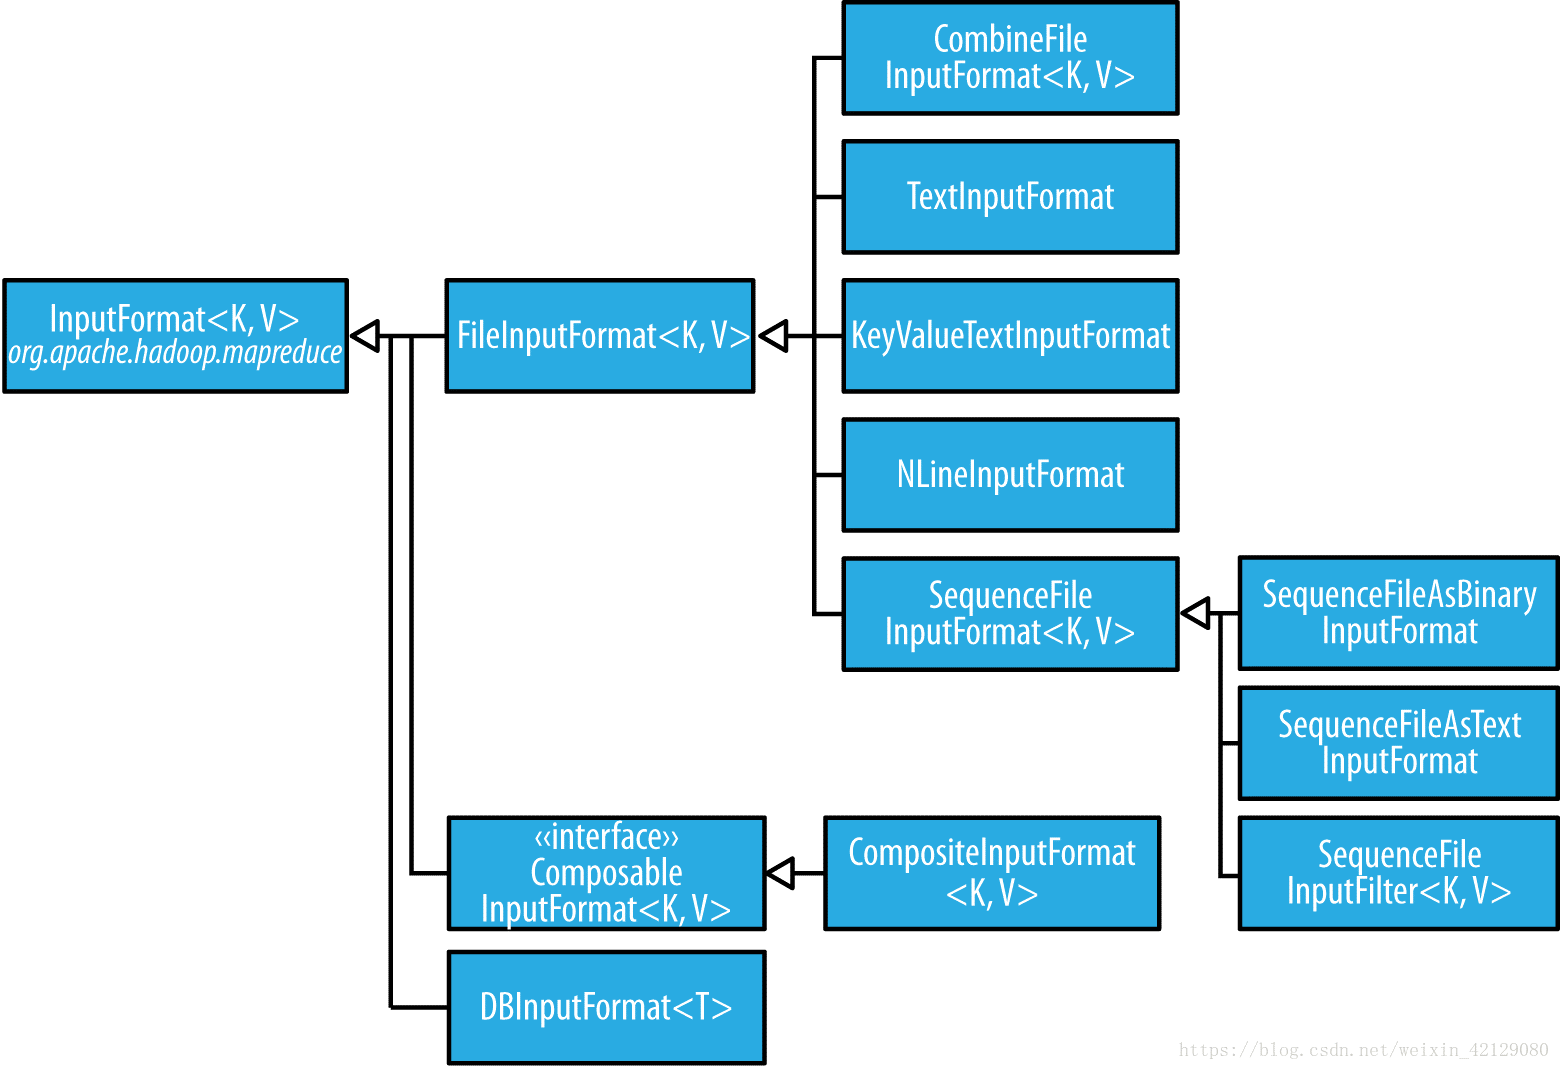
mapreduce框架当中已经给我们提供了很多的文件输入类,用于处理文件数据的输入,如果以上提供的文件数据类还不够用的话,我们也可以通过自定义InputFormat来实现文件数据的输入
-
需求:现在有大量的小文件,我们通过自定义InputFormat实现将小文件全部读取,然后输出成为一个SequenceFile格式的大文件,进行文件的合并
第一步:自定义InputFormat
public class MyInputFormat extends FileInputFormat<NullWritable,BytesWritable> {

    @Override
    public RecordReader<NullWritable, BytesWritable> createRecordReader(InputSplit inputSplit, TaskAttemptContext taskAttemptContext) throws IOException, InterruptedException {
        MyRecordReader myRecordReader = new MyRecordReader();
        myRecordReader.initialize(inputSplit,taskAttemptContext);
        return myRecordReader;
    }
    /**
     * 注意这个方法,决定我们的文件是否可以切分,如果不可切分,直接返回false
     * 到时候读取数据的时候,一次性将文件内容全部都读取出来
     * @param context
     * @param filename
     * @return
     */
    @Override
    protected boolean isSplitable(JobContext context, Path filename) {
        return false;
    }
}
第二步:自定义RecordReader读取数据
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FSDataInputStream;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.BytesWritable;
import org.apache.hadoop.io.IOUtils;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.InputSplit;
import org.apache.hadoop.mapreduce.RecordReader;
import org.apache.hadoop.mapreduce.TaskAttemptContext;
import org.apache.hadoop.mapreduce.lib.input.FileSplit;

import java.io.IOException;

public class MyRecordReader extends RecordReader<NullWritable,BytesWritable> {

    private FileSplit fileSplit ;
    private Configuration configuration;
    private BytesWritable bytesWritable;
//读取文件的标识
    private boolean  flag = false;
    /**
     * 初始化的方法  只在初始化的时候调用一次.只要拿到了文件的切片,就拿到了文件的内容
     * @param inputSplit   输入的文件的切片
     * @param taskAttemptContext
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    public void initialize(InputSplit inputSplit, TaskAttemptContext taskAttemptContext) throws IOException, InterruptedException {
        this.fileSplit = (FileSplit) inputSplit;
       this.configuration = taskAttemptContext.getConfiguration();
       bytesWritable = new BytesWritable();

    }

    /**
     * 读取数据
     * 返回值boolean  类型,如果返回true,表示文件已经读取完成,不用再继续往下读取了
     * 如果返回false,文件没有读取完成,继续读取下一行
     * @return
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    public boolean nextKeyValue() throws IOException, InterruptedException {
        if(!flag){
            long length = fileSplit.getLength();
            byte[] bytes =new byte[(int)length];
            //获取到了文件的切片之后,我们就需要将文件切片的内容获取出来
            Path path = fileSplit.getPath();  //获取文件切片的路径   file:///  hdfs://
            FileSystem fileSystem = path.getFileSystem(configuration);//获取文件系统
            FSDataInputStream open = fileSystem.open(path);//打开文件的输入流
            //已经获取到了文件的输入流,我们需要将流对象,封装到BytesWritable 里面去
            //  inputStream   ==>  byte[]   ==>  BytesWritable
            IOUtils.readFully(open,bytes,0,(int)length);
            bytesWritable.set(bytes,0,(int)length);
            flag = true;
            return true;
        }
        return false;
    }
    /**
     * 获取数据的key1
     * @return
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    public NullWritable getCurrentKey() throws IOException, InterruptedException {
        return NullWritable.get();
    }

    /**
     * 获取数据的value1
     * @return
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    public BytesWritable getCurrentValue() throws IOException, InterruptedException {
        return bytesWritable;
    }

    /**
     * 读取文件的进度,没什么用
     * @return
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    public float getProgress() throws IOException, InterruptedException {
        return flag?1.0f:0.0f;
    }

    /**
     * 关闭资源
     * @throws IOException
     */
    @Override
    public void close() throws IOException {

    }
}
第三步:自定义mapper类
import org.apache.hadoop.io.BytesWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;
import org.apache.hadoop.mapreduce.lib.input.FileSplit;

import java.io.IOException;

public class MyInputFormatMapper extends Mapper<NullWritable,BytesWritable,Text,BytesWritable> {
    @Override
    protected void map(NullWritable key, BytesWritable value, Context context) throws IOException, InterruptedException {
        FileSplit inputSplit = (FileSplit) context.getInputSplit();
        String name = inputSplit.getPath().getName();//获取文件的名称
        context.write(new Text(name),value);
    }
}
第四步:定义main方法
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.BytesWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.output.SequenceFileOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

public class MyInputFormatMain extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {

        Job job = Job.getInstance(super.getConf(), "mergeSmallFile");
        job.setInputFormatClass(MyInputFormat.class);
        MyInputFormat.addInputPath(job,new Path("file:///D:\\4、自定义InputFormat实现小文件合并\\文件数据"));

        job.setMapperClass(MyInputFormatMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(BytesWritable.class);

        //没有reduce。但是要设置reduce的输出的k3   value3 的类型
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(BytesWritable.class);

//将我们的文件输出成为sequenceFile这种格式
        job.setOutputFormatClass(SequenceFileOutputFormat.class);

        SequenceFileOutputFormat.setOutputPath(job,new Path("file:///D:\\4、自定义InputFormat实现小文件合并\\文件数据\\out_sequence"));

        boolean b = job.waitForCompletion(true);
        return b?0:1;
    }

    public static void main(String[] args) throws Exception {
        int run = ToolRunner.run(new Configuration(), new MyInputFormatMain(), args);
        System.exit(run);
    }

}
10. mapreduce的partitioner详解
-
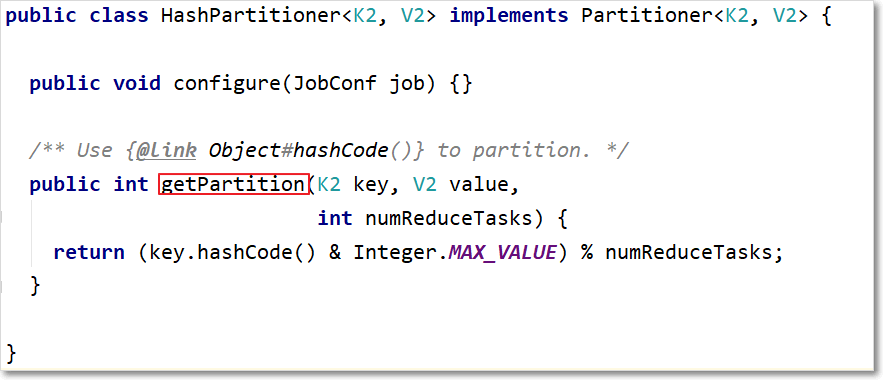
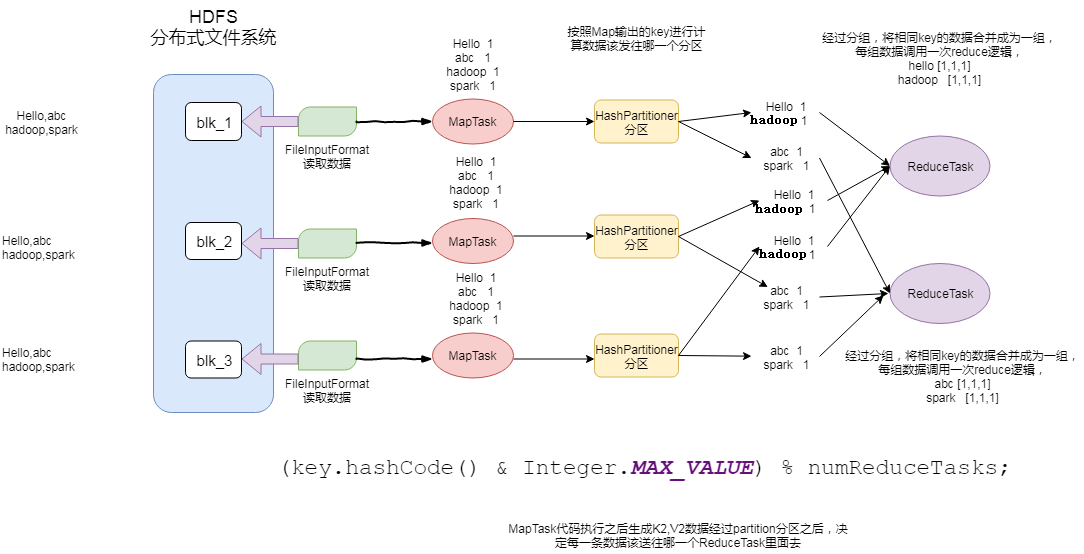
在mapreduce执行当中,有一个默认的步骤就是partition分区,分区主要的作用就是将相同的数据发送到同一个reduceTask里面去,在mapreduce当中有一个抽象类叫做Partitioner,默认使用的实现类是HashPartitioner,我们可以通过HashPartitioner的源码,查看到分区的逻辑如下
-
我们MR编程的第三步就是分区;这一步中决定了map生成的每个kv对,被分配到哪个分区里
-
那么这是如何做到的呢?
-
要实现此功能,涉及到了分区器的概念;
1. 默认分区器HashPartitioner
- MR框架有个默认的分区器HashPartitioner
-
我们能观察到:
- HashPartitioner实现了Partitioner接口
- 它实现了getPartition()方法
- 此方法中对k取hash值
- 再与MAX_VALUE按位与
- 结果再模上reduce任务的个数
- 所以,能得出结论,相同的key会落入同一个分区中
2. 自定义分区器
-
实际生产中,有时需要自定义分区的逻辑,让key落入我们想让它落入的分区
-
此时就需要自定义分区器
-
如何实现?
-
参考默认分区器HashPartitioner
- 自定义的分区器类,如CustomPartitioner
- 实现接口Partitioner
- 实现getPartition方法;此方法中定义分区的逻辑
- main方法
- 将自定义的分区器逻辑添加进来job.setPartitionerClassCustomPartitioner.class)
- 设置对应的reduce任务个数job.setNumReduceTasks(3)
- 自定义的分区器类,如CustomPartitioner
-
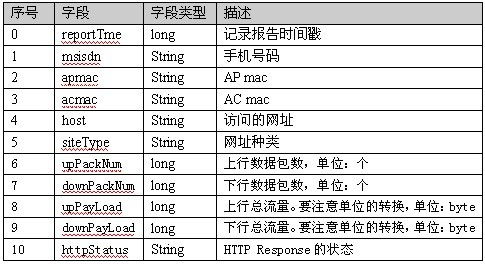
现有一份关于手机的流量数据,样本数据如下

-
数据格式说明
-
需求:使用mr,实现将不同的手机号的数据划分到6个不同的文件里面去,具体划分规则如下
135开头的手机号分到一个文件里面去,
136开头的手机号分到一个文件里面去,
137开头的手机号分到一个文件里面去,
138开头的手机号分到一个文件里面去,
139开头的手机号分到一个文件里面去,
其他开头的手机号分到一个文件里面去
- 代码实现
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Partitioner;

public class PartitionOwn extends Partitioner<Text, FlowBean> {

    @Override
    public int getPartition(Text text, FlowBean flowBean, int numPartitions) {
        String phoenNum = text.toString();
        if(null != phoenNum && !phoenNum.equals("")){
            if(phoenNum.startsWith("135")){
                return 0;
            }else if(phoenNum.startsWith("136")){
                return 1;
            }else if(phoenNum.startsWith("137")){
                return 2;
            }else if(phoenNum.startsWith("138")){
                return 3;
            }else if(phoenNum.startsWith("139")){
                return 4;
            }else {
                return 5;
            }
        }else{
            return 5;
        }
    }
}
- main方法中
job.setPartitionerClass(PartitionOwn.class); //设置分区器
job.setNumReduceTasks(6); //设置reduce task个数
-
注意:对于我们自定义分区的案例,必须打成jar包上传到集群上面去运行,因为我们本地已经没法通过多线程模拟本地程序运行了,将我们的数据上传到hdfs上面去,然后通过 hadoop jar提交到集群上面去运行,观察我们分区的个数与reduceTask个数的关系
-
思考:如果手动指定6个分区,reduceTask个数设置为3个会出现什么情况
如果手动指定6个分区,reduceTask个数设置为9个会出现什么情况
11. mapreduce当中的排序
-
排序是MapReduce框架中最重要的操作之一。
-
MapTask和ReduceTask均会对数据按照key进行排序。该操作属于Hadoop的默认行为。任何应用程序中的数据均会被排序,而不管逻辑上是否需要。
-
默认排序是按照字典顺序排序,且实现该排序的方法是快速排序。
-
对于MapTask,它会将处理的结果暂时放到环形缓冲区中,当环形缓冲区使用率达到一定阈值后,再对缓冲区中的数据进行一次快速排序,并将这些有序数据溢写到磁盘上,而当数据处理完毕后,它会对磁盘上所有文件进行归并排序。
-
对于ReduceTask,它从每个MapTask上远程拷贝相应的数据文件,如果文件大小超过一定阈值,则溢写磁盘上,否则存储在内存中。如果磁盘上文件数目达到一定阈值,则进行一次归并排序以生成一个更大文件;如果内存中文件大小或者数目超过一定阈值,则进行一次合并后将数据溢写到磁盘上。当所有数据拷贝完毕后,ReduceTask统一对内存和磁盘上的所有数据进行一次归并排序。
-
各种排序的分类:
-
1、部分排序
MapReduce根据输入记录的键对数据集排序。保证输出的每个文件内部有序
-
2、全排序
最终输出结果只有一个文件,且文件内部有序。实现方式是只设置一个ReduceTask。但该方法在处理大型文件时效率极低,因为一台机器处理所有文件,完全丧失了MapReduce所提供的并行架构
-
3、辅助排序
在Reduce端对key进行分组。应用于:在接收的key为bean对象时,想让一个或几个字段相同(全部字段比较不相同)的key进入到同一个reduce方法时,可以采用分组排序。
-
4、二次排序
在自定义排序过程中,如果compareTo中的判断条件为两个即为二次排序。
-
-
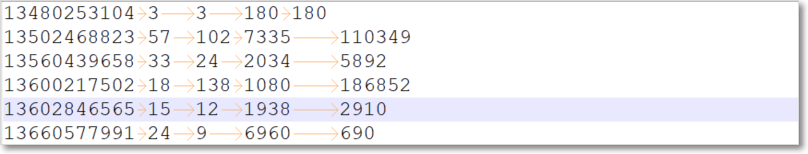
现有数据,样本数据如下;
每条数据有5个字段,分别是手机号、上行包总个数、下行包总个数、上行总流量、下行总流量
-
需求先对下行包总个数升序排序;若相等,再按上行总流量进行降序排序
-
代码实现:
-
定义javaBean对象,用于封装数据
import org.apache.hadoop.io.WritableComparable;

import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;

//bean要能够可序列化且可比较,所以需要实现接口WritableComparable
public class FlowSortBean implements WritableComparable<FlowSortBean> {
    private String phone;
    //上行包个数
    private Integer upPackNum;
    //下行包个数
    private Integer downPackNum;
    //上行总流量
    private Integer upPayLoad;
    //下行总流量
    private Integer downPayLoad;

    //用于比较两个FlowSortBean对象
    @Override
    public int compareTo(FlowSortBean o) {
        //升序
        int i = this.downPackNum.compareTo(o.downPackNum);
        if (i == 0) {
            //降序
            i = -this.upPayLoad.compareTo(o.upPayLoad);
        }
        return i;
    }

    //序列化
    @Override
    public void write(DataOutput out) throws IOException {
        out.writeUTF(phone);
        out.writeInt(upPackNum);
        out.writeInt(downPackNum);
        out.writeInt(upPayLoad);
        out.writeInt(downPayLoad);
    }

    //反序列化
    @Override
    public void readFields(DataInput in) throws IOException {
        this.phone = in.readUTF();
        this.upPackNum = in.readInt();
        this.downPackNum = in.readInt();
        this.upPayLoad = in.readInt();
        this.downPayLoad = in.readInt();
    }

    @Override
    public String toString() {
        return phone + "\t" + upPackNum + "\t" + downPackNum + "\t" + upPayLoad + "\t" + downPayLoad;
    }

    //setter、getter方法
    public String getPhone() {
        return phone;
    }

    public void setPhone(String phone) {
        this.phone = phone;
    }

    public Integer getUpPackNum() {
        return upPackNum;
    }

    public void setUpPackNum(Integer upPackNum) {
        this.upPackNum = upPackNum;
    }

    public Integer getDownPackNum() {
        return downPackNum;
    }

    public void setDownPackNum(Integer downPackNum) {
        this.downPackNum = downPackNum;
    }

    public Integer getUpPayLoad() {
        return upPayLoad;
    }

    public void setUpPayLoad(Integer upPayLoad) {
        this.upPayLoad = upPayLoad;
    }

    public Integer getDownPayLoad() {
        return downPayLoad;
    }

    public void setDownPayLoad(Integer downPayLoad) {
        this.downPayLoad = downPayLoad;
    }
}
- 定义mapper类
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class FlowSortMapper extends Mapper<LongWritable, Text, FlowSortBean, NullWritable> {

    private FlowSortBean flowSortBean;

    //初始化
    @Override
    protected void setup(Context context) throws IOException, InterruptedException {
        flowSortBean = new FlowSortBean();
    }

    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        /**
         * 手机号	上行包	下行包	上行总流量	下行总流量
         * 13480253104	3	3	180	180
         */
        String[] split = value.toString().split("\t");

        flowSortBean.setPhone(split[0]);
        flowSortBean.setUpPackNum(Integer.parseInt(split[1]));
        flowSortBean.setDownPackNum(Integer.parseInt(split[2]));
        flowSortBean.setUpPayLoad(Integer.parseInt(split[3]));
        flowSortBean.setDownPayLoad(Integer.parseInt(split[4]));

        context.write(flowSortBean, NullWritable.get());
    }
}
- 定义reducer类
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class FlowSortReducer extends Reducer<FlowSortBean, NullWritable, FlowSortBean, NullWritable> {

    @Override
    protected void reduce(FlowSortBean key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException {
        //经过排序后的数据,直接输出即可
        context.write(key, NullWritable.get());
    }
}
- 定义main方法
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

public class FlowSortMain extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {
        //获取job对象
        Job job = Job.getInstance(super.getConf(), "flowSort");
        //如果程序打包运行必须要设置这一句
        job.setJarByClass(FlowSortMain.class);

        job.setInputFormatClass(TextInputFormat.class);
        TextInputFormat.addInputPath(job,new Path(args[0]));

        job.setMapperClass(FlowSortMapper.class);
        job.setMapOutputKeyClass(FlowSortBean.class);
        job.setMapOutputValueClass(NullWritable.class);

        job.setReducerClass(FlowSortReducer.class);
        job.setOutputKeyClass(FlowSortBean.class);
        job.setOutputValueClass(NullWritable.class);

        job.setOutputFormatClass(TextOutputFormat.class);
        TextOutputFormat.setOutputPath(job,new Path(args[1]));

        boolean b = job.waitForCompletion(true);

        return b?0:1;
    }


    public static void main(String[] args) throws Exception {
        Configuration configuration = new Configuration();
        int run = ToolRunner.run(configuration, new FlowSortMain(), args);
        System.exit(run);
    }

}
12. mapreduce当中的combiner
-
combiner基本介绍
-
combiner类本质也是reduce聚合,需要继承Reducer父类
-
combine是运行在map端的,对map task的结果做聚合;而reduce是将来自不同的map task的数据做聚合
-
combine可以减少map task落盘及向reduce task传输的数据量
-
并非所有的mapreduce job都适用combine,无论适不适用combine,都不能对最终的结果造成影响;比如下边求平均值的例子,就不适用适用combine
Mapper
3 5 7 ->(3+5+7)/3=5
2 6 ->(2+6)/2=4

Reducer
(3+5+7+2+6)/5=23/5    不等于    (5+4)/2=9/2
-
-
需求:对于我们前面的wordCount单词计数统计,我们加上Combiner过程,实现map端的数据进行汇总之后,再发送到reduce端,减少数据的网络拷贝
-
自定义combiner类
其实直接使用词频统计中的reducer类作为combine类即可
-
在main方法中加入
job.setCombinerClass(MyReducer.class);
- 运行程序,观察控制台有combiner和没有combiner的异同

13. mapreduce当中的GroupingComparator分组详解
- GroupingComparator是mapreduce当中reduce端的一个功能组件,主要的作用是决定哪些数据作为一组,调用一次reduce的逻辑,默认是每个不同的key,作为多个不同的组,每个组调用一次reduce逻辑,我们可以自定义GroupingComparator实现不同的key作为同一个组,调用一次reduce逻辑
1. 分组排序步骤:
- (1)自定义类继承WritableComparator
- (2)重写compare()方法
@Override
public int compare(WritableComparable a, WritableComparable b) {
        // 比较的业务逻辑
        return result;
}
- (3)创建一个构造将比较对象的类传给父类
protected OrderGroupingComparator() {
        super(OrderBean.class, true);
}
2. 需求:现在有订单数据如下
| 订单id | 商品id | 成交金额 |
|---|---|---|
| Order_0000001 | Pdt_01 | 222.8 |
| Order_0000001 | Pdt_05 | 25.8 |
| Order_0000002 | Pdt_03 | 522.8 |
| Order_0000002 | Pdt_04 | 122.4 |
| Order_0000002 | Pdt_05 | 722.4 |
| Order_0000003 | Pdt_01 | 222.8 |
- 现在需要求取每个订单当中金额最大的商品
3. 自定义OrderBean对象
import org.apache.hadoop.io.WritableComparable;

import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;

public class OrderBean implements WritableComparable<OrderBean> {
    private String orderId;
    private Double price;

    /**
     * key间的比较规则
     *
     * @param o
     * @return
     */
    @Override
    public int compareTo(OrderBean o) {
        //注意:如果是不同的订单之间,金额不需要排序,没有可比性
        int orderIdCompare = this.orderId.compareTo(o.orderId);
        if (orderIdCompare == 0) {
            //比较金额,按照金额进行倒序排序
            int priceCompare = this.price.compareTo(o.price);
            return -priceCompare;
        } else {
            //如果订单号不同,没有可比性,直接返回订单号的升序排序即可
            return orderIdCompare;
        }
    }

    /**
     * 序列化方法
     *
     * @param out
     * @throws IOException
     */
    @Override
    public void write(DataOutput out) throws IOException {
        out.writeUTF(orderId);
        out.writeDouble(price);
    }

    /**
     * 反序列化方法
     *
     * @param in
     * @throws IOException
     */
    @Override
    public void readFields(DataInput in) throws IOException {
        this.orderId = in.readUTF();
        this.price = in.readDouble();
    }

    public String getOrderId() {
        return orderId;
    }

    public void setOrderId(String orderId) {
        this.orderId = orderId;
    }

    public Double getPrice() {
        return price;
    }

    public void setPrice(Double price) {
        this.price = price;
    }

    @Override
    public String toString() {
        return orderId + "\t" + price;
    }
}
4. 自定义mapper类:
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class GroupMapper extends Mapper<LongWritable, Text, OrderBean, NullWritable> {

    /**
     * Order_0000001	Pdt_01	222.8
     * Order_0000001	Pdt_05	25.8
     * Order_0000002	Pdt_03	322.8
     * Order_0000002	Pdt_04	522.4
     * Order_0000002	Pdt_05	822.4
     * Order_0000003	Pdt_01	222.8
     * Order_0000003	Pdt_03	322.8
     * Order_0000003	Pdt_04	522.4
     *
     * @param key
     * @param value
     * @param context
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        String[] fields = value.toString().split("\t");

        OrderBean orderBean = new OrderBean();
        orderBean.setOrderId(fields[0]);
        orderBean.setPrice(Double.valueOf(fields[2]));

        //输出orderBean
        context.write(orderBean, NullWritable.get());
    }
}
5. 自定义分区类:
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.Partitioner;

public class GroupPartitioner extends Partitioner<OrderBean, NullWritable> {
    @Override
    public int getPartition(OrderBean orderBean, NullWritable nullWritable, int numPartitions) {
        //将每个订单的所有的记录,传入到一个reduce当中
        return orderBean.getOrderId().hashCode() % numPartitions;
    }
}
6. 自定义分组类:
import org.apache.hadoop.io.WritableComparable;
import org.apache.hadoop.io.WritableComparator;

public class MyGroup extends WritableComparator {
    public MyGroup() {
        //分组类:要对OrderBean类型的k进行分组
        super(OrderBean.class, true);
    }

    @Override
    public int compare(WritableComparable a, WritableComparable b) {
        OrderBean a1 = (OrderBean) a;
        OrderBean b1 = (OrderBean) b;
        //需要将同一订单的kv作为一组
        return a1.getOrderId().compareTo(b1.getOrderId());
    }
}
7. 自定义reduce类
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class GroupReducer extends Reducer<OrderBean, NullWritable, OrderBean, NullWritable> {

    /**
     * Order_0000002	Pdt_03	322.8
     * Order_0000002	Pdt_04	522.4
     * Order_0000002	Pdt_05	822.4
     * => 这一组中有3个kv
     * 并且是排序的
     * Order_0000002	Pdt_05	822.4
     * Order_0000002	Pdt_04	522.4
     * Order_0000002	Pdt_03	322.8
     *
     * @param key
     * @param values
     * @param context
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    protected void reduce(OrderBean key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException {
        //Order_0000002	Pdt_05	822.4 获得了当前订单中进而最高的商品
        context.write(key, NullWritable.get());
    }
}
8. 定义程序入口类
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.conf.Configured;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
import org.apache.hadoop.util.Tool;
import org.apache.hadoop.util.ToolRunner;

/**
 * 分组求top 1
 */
public class GroupMain extends Configured implements Tool {
    @Override
    public int run(String[] args) throws Exception {
        //获取job对象
        Job job = Job.getInstance(super.getConf(), "group");
        job.setJarByClass(GroupMain.class);

        //第一步:读取文件,解析成为key,value对
        job.setInputFormatClass(TextInputFormat.class);
        TextInputFormat.addInputPath(job, new Path(args[0]));

        //第二步:自定义map逻辑
        job.setMapperClass(GroupMapper.class);
        job.setMapOutputKeyClass(OrderBean.class);
        job.setMapOutputValueClass(NullWritable.class);

        //第三步:分区
        job.setPartitionerClass(GroupPartitioner.class);

        //第四步:排序  已经做了

        //第五步:规约  combiner  省掉

        //第六步:分组   自定义分组逻辑
        job.setGroupingComparatorClass(MyGroup.class);

        //第七步:设置reduce逻辑
        job.setReducerClass(GroupReducer.class);
        job.setOutputKeyClass(OrderBean.class);
        job.setOutputValueClass(NullWritable.class);

        //第八步:设置输出路径
        job.setOutputFormatClass(TextOutputFormat.class);
        TextOutputFormat.setOutputPath(job, new Path(args[1]));

        //如果设置reduce任务数为多个,必须打包到集群运行
        job.setNumReduceTasks(3);

        boolean b = job.waitForCompletion(true);
        return b ? 0 : 1;
    }

    public static void main(String[] args) throws Exception {
        int run = ToolRunner.run(new Configuration(), new GroupMain(), args);
        System.exit(run);
    }
}
- 拓展:如何求每个组当中的top2的订单金额数据???
14. map task工作机制
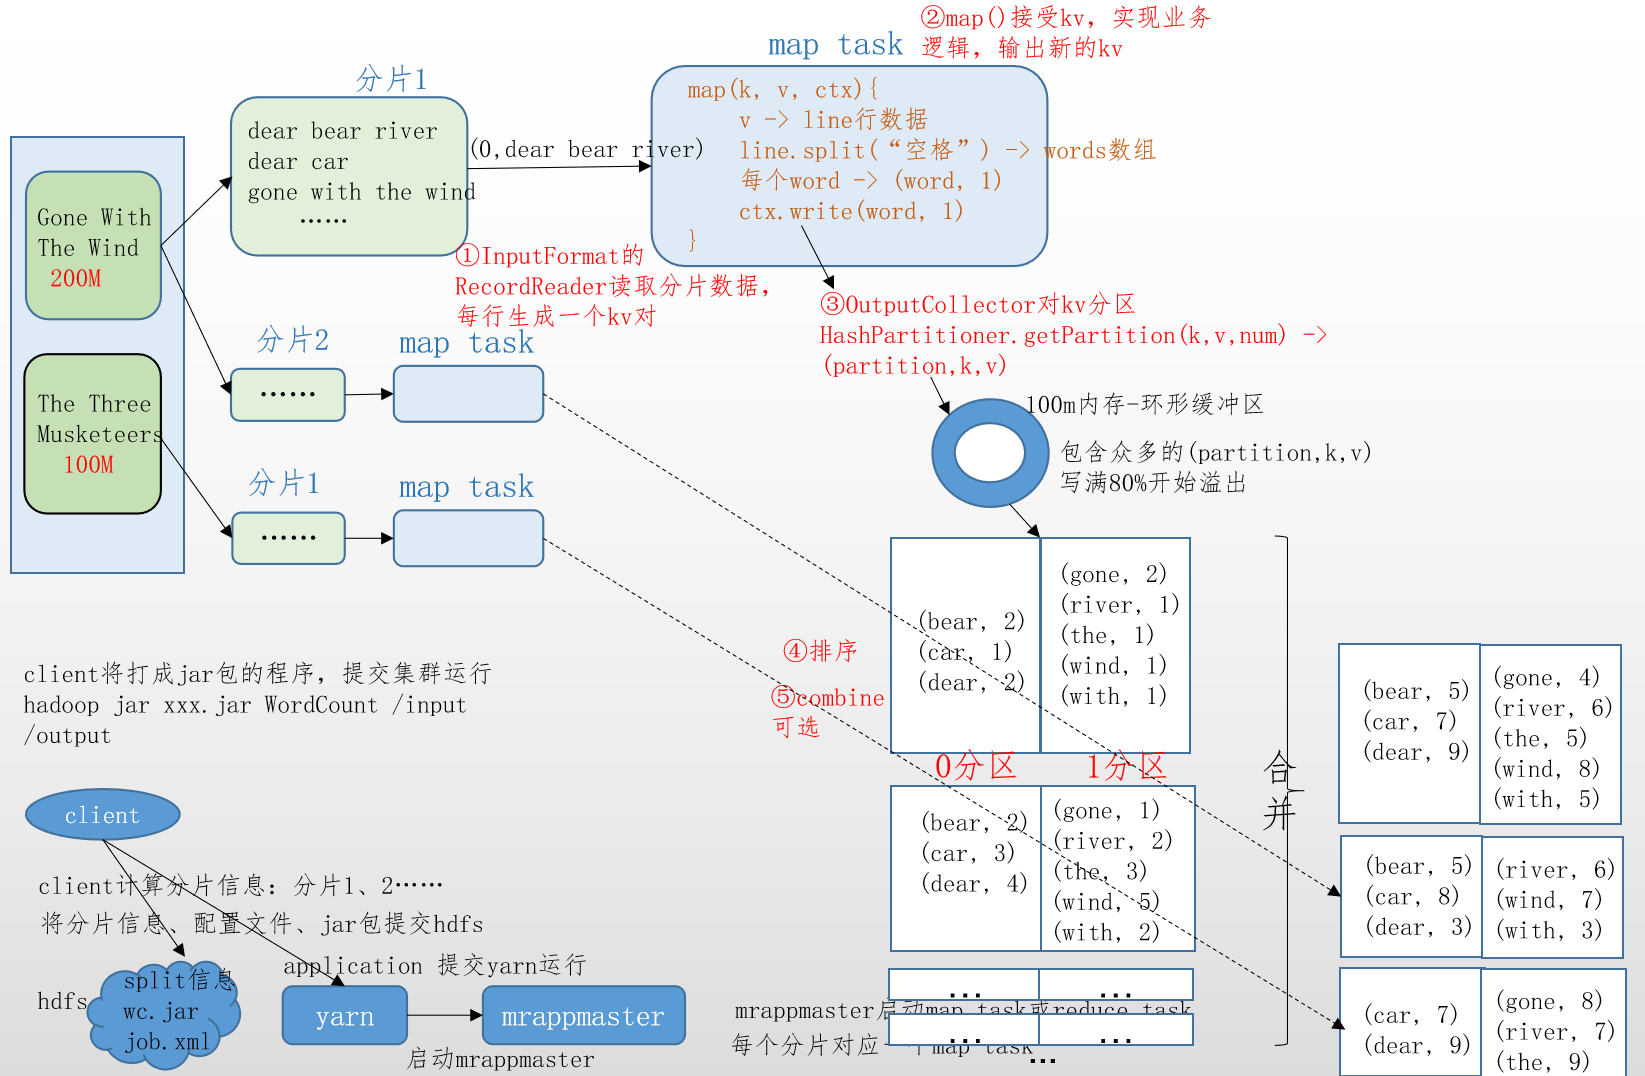
-
(1)Read阶段:MapTask通过用户编写的RecordReader,从输入InputSplit中解析出一个个key/value。
-
(2)Map阶段:该节点主要是将解析出的key/value交给用户编写map()函数处理,并产生一系列新的key/value。
-
(3)Collect收集阶段:在用户编写map()函数中,当数据处理完成后,一般会调用OutputCollector.collect()输出结果。在该函数内部,它会将生成的key/value分区(调用Partitioner),并写入一个环形内存缓冲区中。
-
(4)Spill阶段:即“溢写”,当环形缓冲区满80%后,MapReduce会将数据写到本地磁盘上,生成一个临时文件。需要注意的是,将数据写入本地磁盘之前,先要对数据进行一次本地排序,并在必要时对数据进行合并、压缩等操作。
-
溢写阶段详情:
-
步骤1:利用快速排序算法对缓存区内的数据进行排序,排序方式是,先按照分区编号Partition进行排序,然后按照key进行排序。这样,经过排序后,数据以分区为单位聚集在一起,且同一分区内所有数据按照key有序。
-
步骤2:按照分区编号由小到大依次将每个分区中的数据写入任务工作目录下的临时文件output/spillN.out(N表示当前溢写次数)中。如果用户设置了Combiner,则写入文件之前,对每个分区中的数据进行一次聚集操作。
-
步骤3:将分区数据的元信息写到内存索引数据结构SpillRecord中,其中每个分区的元信息包括在临时文件中的偏移量、压缩前数据大小和压缩后数据大小。如果当前内存索引大小超过1MB,则将内存索引写到文件output/spillN.out.index中。
-
(5)Combine阶段:当所有数据处理完成后,MapTask对所有临时文件进行一次合并,以确保最终只会生成一个数据文件。
-
当所有数据处理完后,MapTask会将所有临时文件合并成一个大文件,并保存到文件output/file.out中,同时生成相应的索引文件output/file.out.index。
-
在进行文件合并过程中,MapTask以分区为单位进行合并。对于某个分区,它将采用多轮递归合并的方式。每轮合并io.sort.factor(默认10)个文件,并将产生的文件重新加入待合并列表中,对文件排序后,重复以上过程,直到最终得到一个大文件。
-
让每个MapTask最终只生成一个数据文件,可避免同时打开大量文件和同时读取大量小文件产生的随机读取带来的开销。
-
15. reduce task工作机制
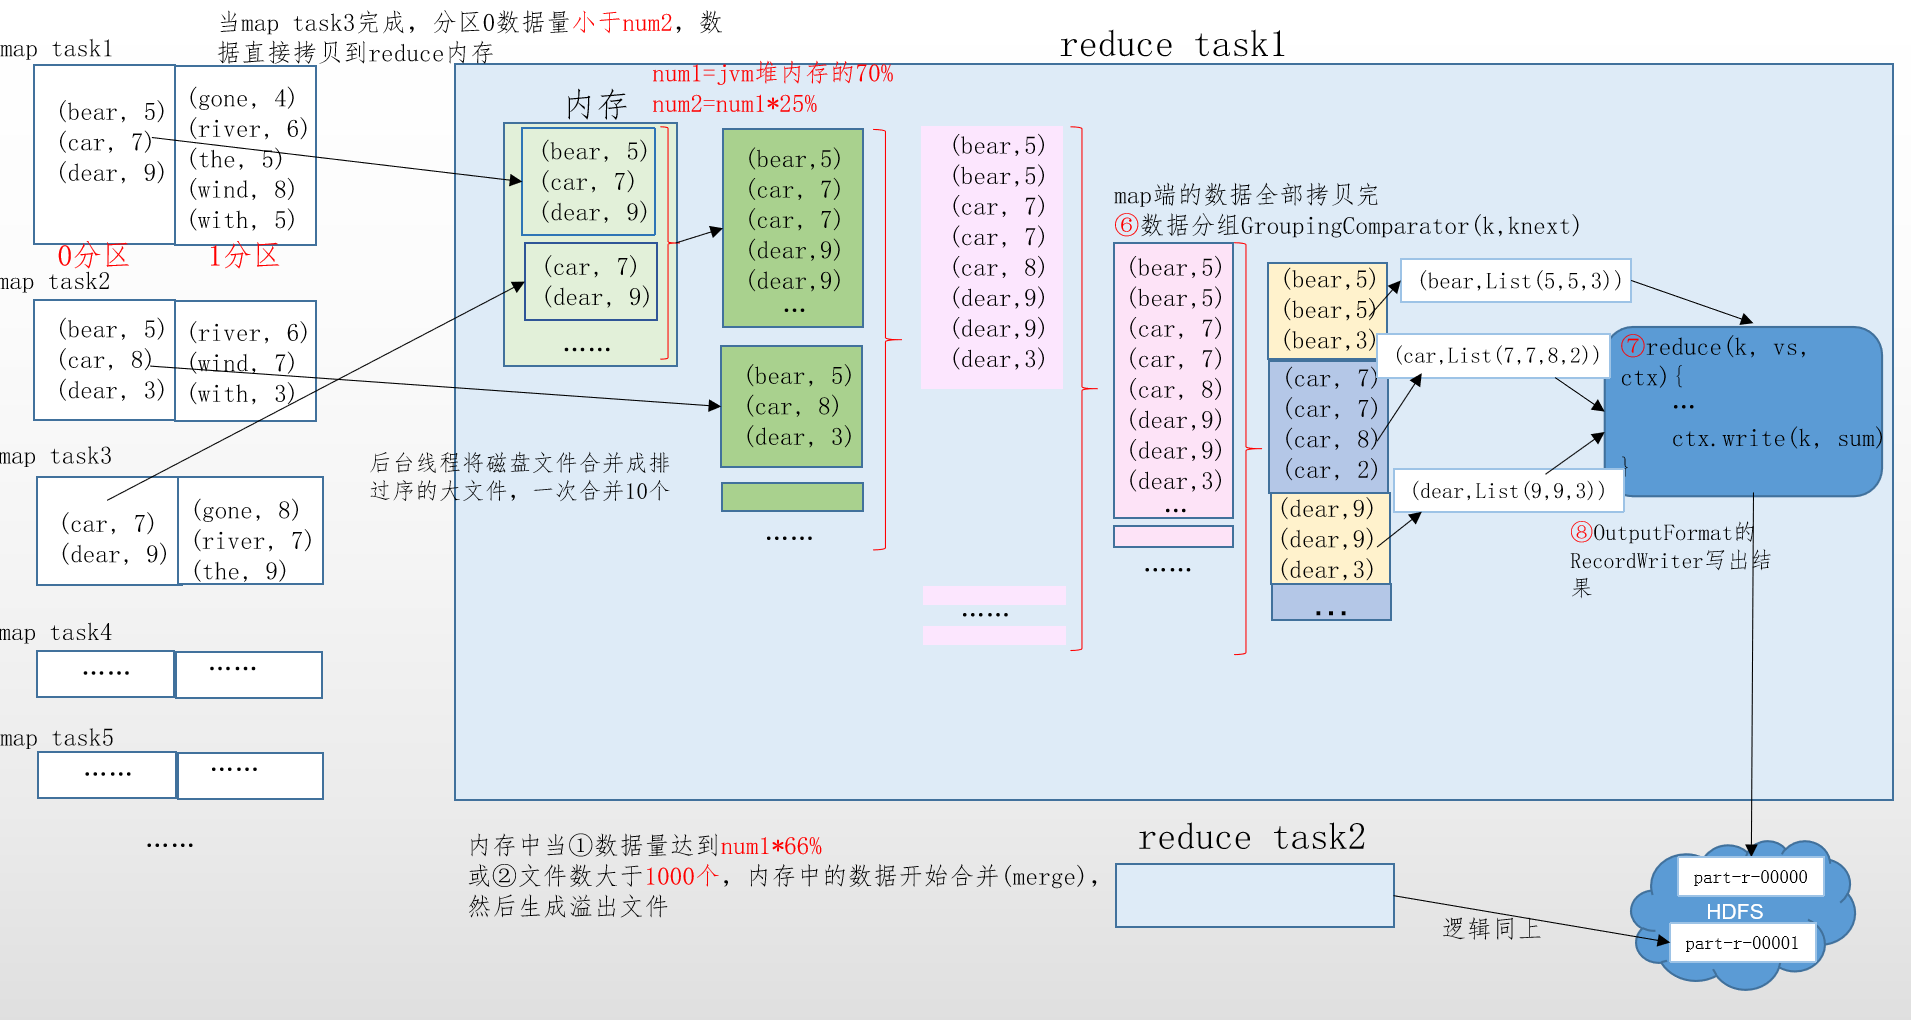
1. reduce流程
-
(1)Copy阶段:ReduceTask从各个MapTask上远程拷贝一片数据,并针对某一片数据,如果其大小超过一定阈值,则写到磁盘上,否则直接放到内存中。
-
(2)Merge阶段:在远程拷贝数据的同时,ReduceTask启动了两个后台线程对内存和磁盘上的文件进行合并,以防止内存使用过多或磁盘上文件过多。
-
(3)Sort阶段:当所有map task的分区数据全部拷贝完,按照MapReduce语义,用户编写reduce()函数输入数据是按key进行聚集的一组数据。为了将key相同的数据聚在一起,Hadoop采用了基于排序的策略。由于各个MapTask已经实现对自己的处理结果进行了局部排序,因此,ReduceTask只需对所有数据进行一次归并排序即可。
-
(4)Reduce阶段:reduce()函数将计算结果写到HDFS上。
2. 设置ReduceTask并行度(个数)
-
ReduceTask的并行度同样影响整个Job的执行并发度和执行效率,但与MapTask的并发数由切片数决定不同,ReduceTask数量的决定是可以直接手动设置:
// 默认值是1,手动设置为4
job.setNumReduceTasks(4);
3. 实验:测试ReduceTask多少合适
-
(1)实验环境:1个Master节点,16个Slave节点:CPU:8GHZ,内存: 2G
-
(2)实验结论:
-
表4-3 改变ReduceTask (数据量为1GB)
| MapTask =16 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| ReduceTask | 1 | 5 | 10 | 15 | 16 | 20 | 25 | 30 | 45 | 60 |
| 总时间 | 892 | 146 | 110 | 92 | 88 | 100 | 128 | 101 | 145 | 104 |
16. mapreduce完整流程
1. map简图
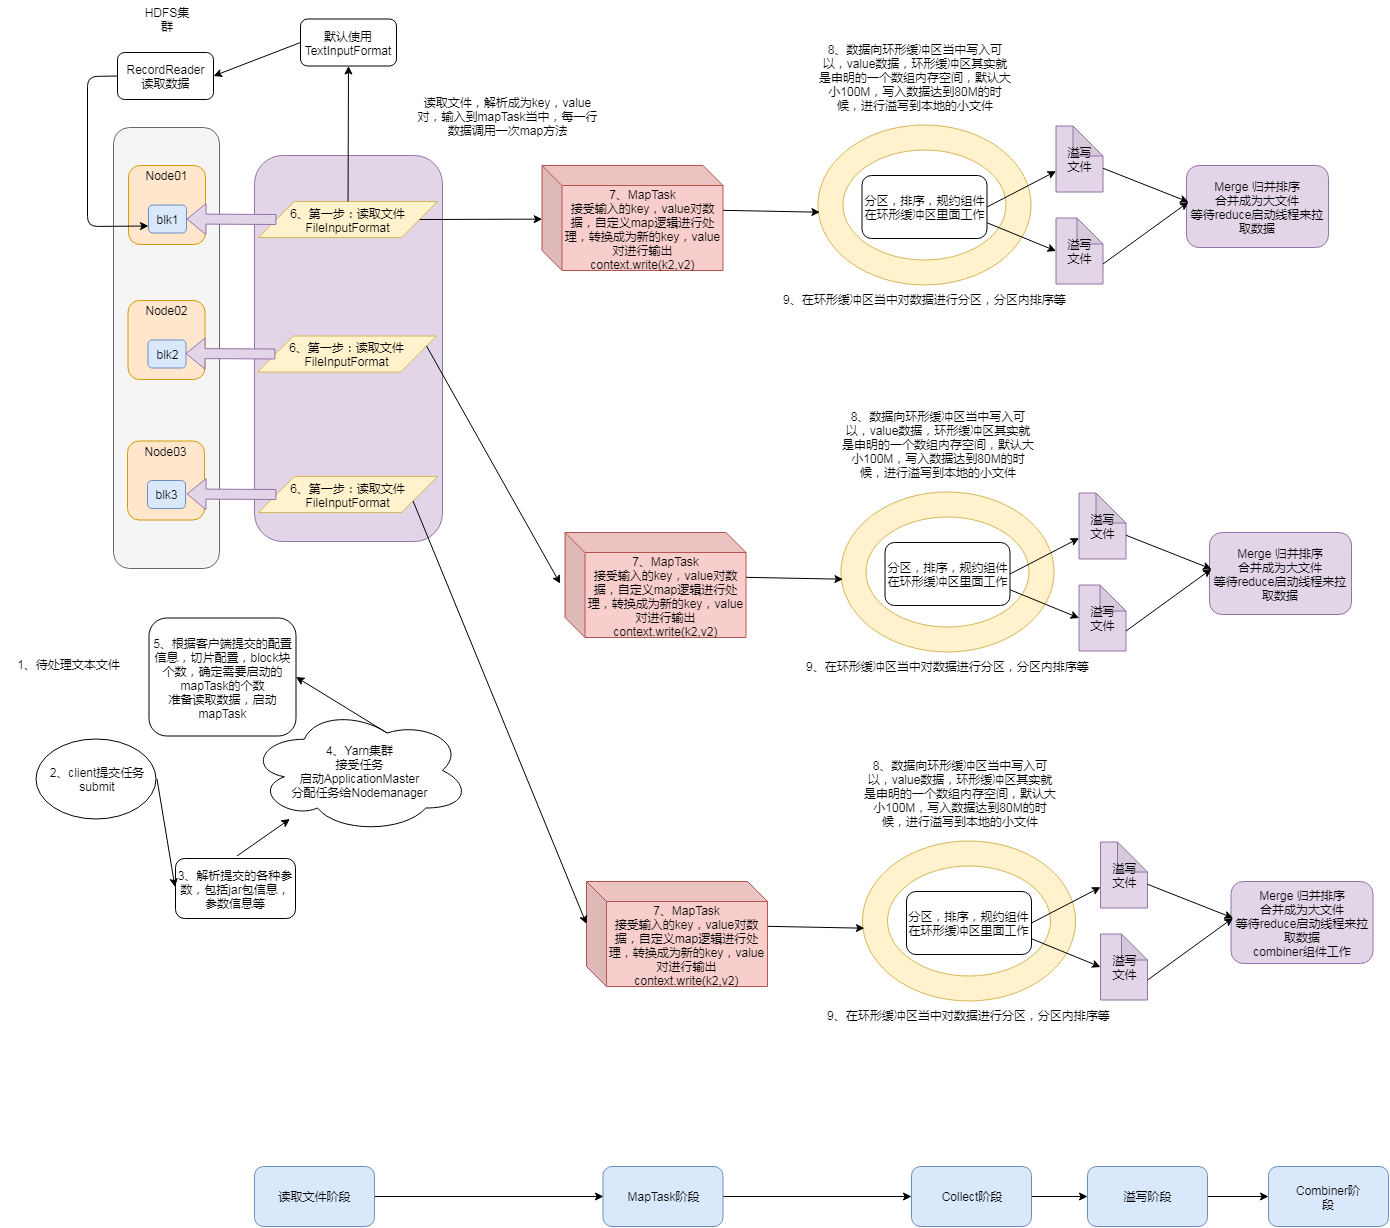
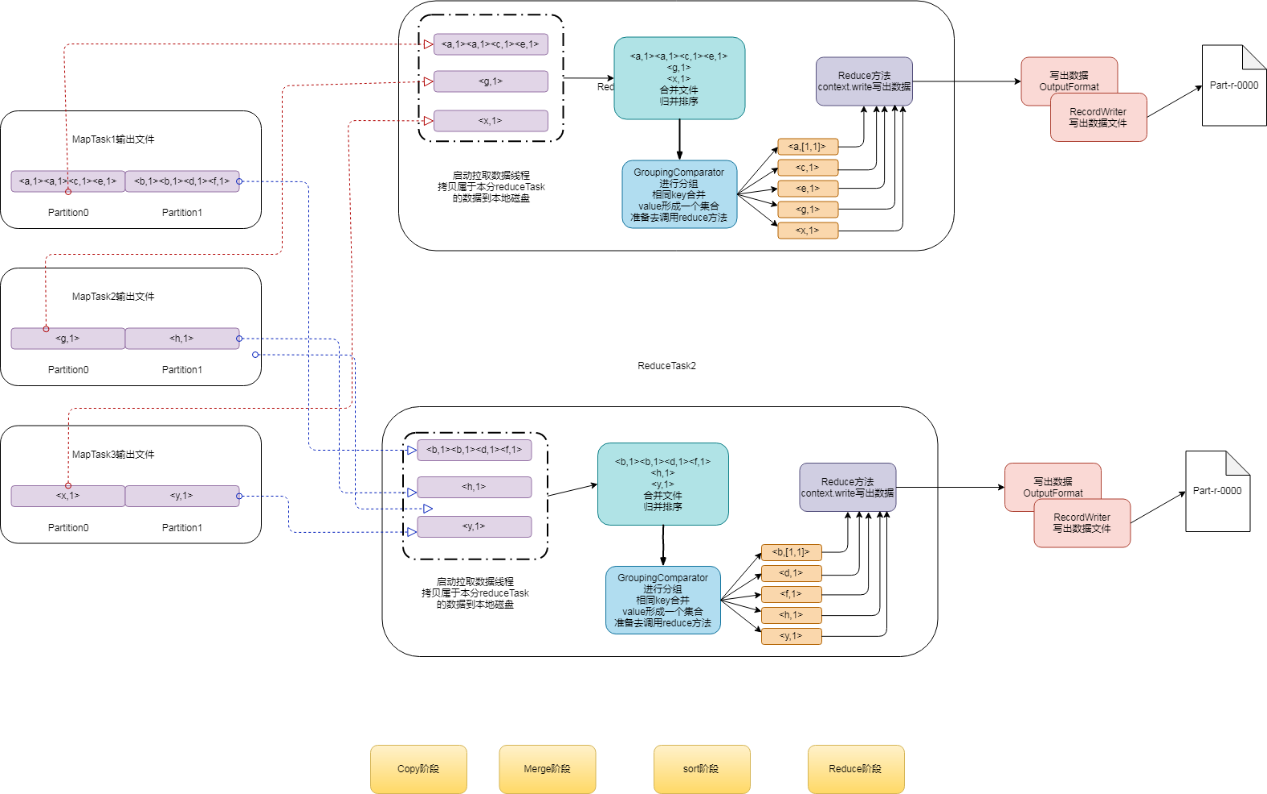
2. reduce简图
3. mapreduce简略步骤
-
第一步:读取文件,解析成为key,value对
-
第二步:自定义map逻辑接受k1,v1,转换成为新的k2,v2输出;写入环形缓冲区
-
第三步:分区:写入环形缓冲区的过程,会给每个kv加上分区Partition index。(同一分区的数据,将来会被发送到同一个reduce里面去)
-
第四步:排序:当缓冲区使用80%,开始溢写文件
- 先按partition进行排序,相同分区的数据汇聚到一起;
- 然后,每个分区中的数据,再按key进行排序
-
第五步:combiner。调优过程,对数据进行map阶段的合并(注意:并非所有mr都适合combine)
-
第六步:将环形缓冲区的数据进行溢写到本地磁盘小文件
-
第七步:归并排序,对本地磁盘溢写小文件进行归并排序
-
第八步:等待reduceTask启动线程来进行拉取数据
-
第九步:reduceTask启动线程,从各map task拉取属于自己分区的数据
-
第十步:从mapTask拉取回来的数据继续进行归并排序
-
第十一步:进行groupingComparator分组操作
-
第十二步:调用reduce逻辑,写出数据
-
第十三步:通过outputFormat进行数据输出,写到文件,一个reduceTask对应一个结果文件