Capacity Scheduler-扩展
2026-08-24
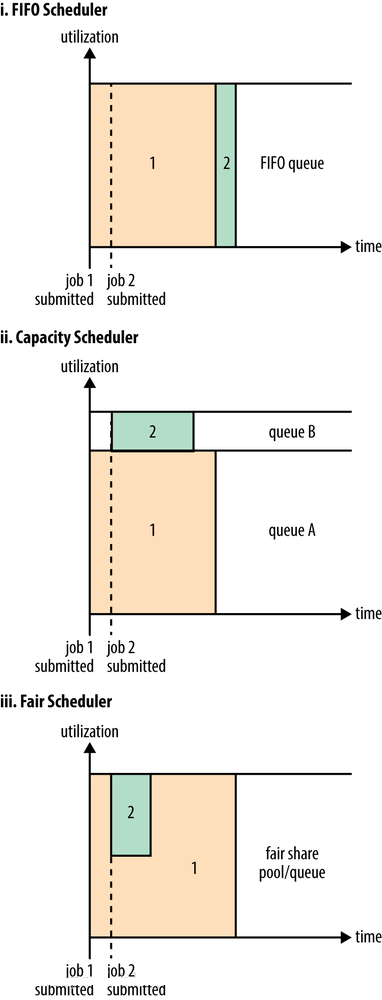
Capacity Scheduler
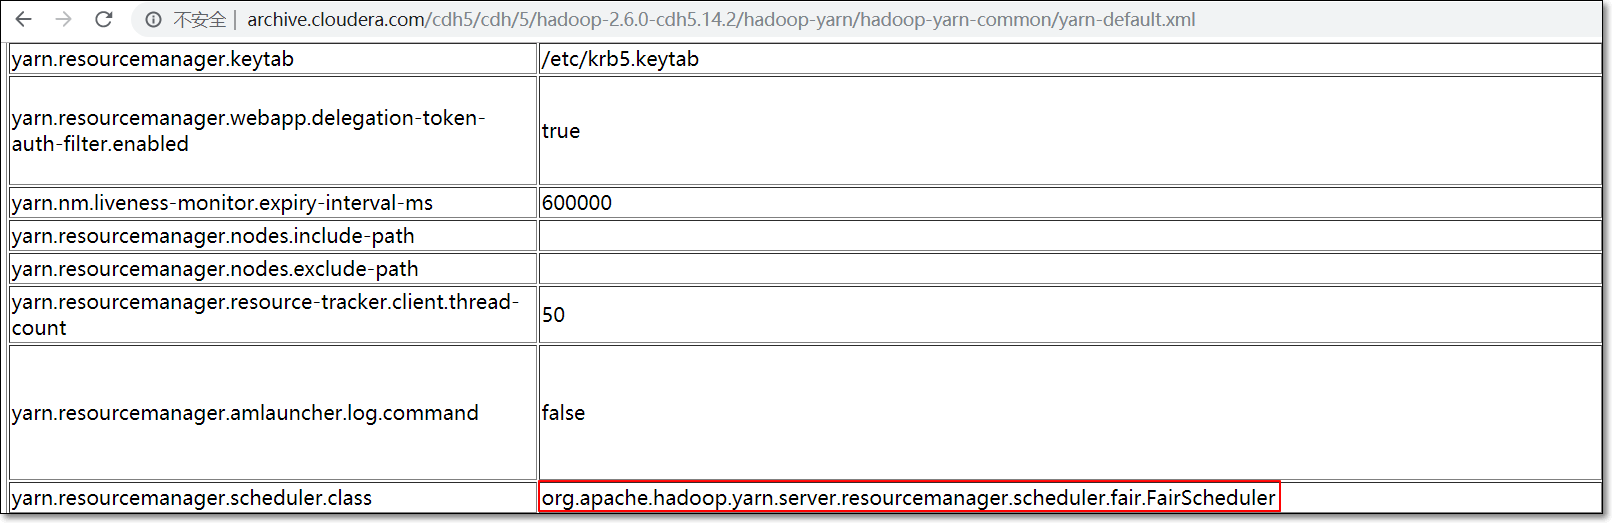
- CDH版本默认使用Fair Scheduler公平调度器
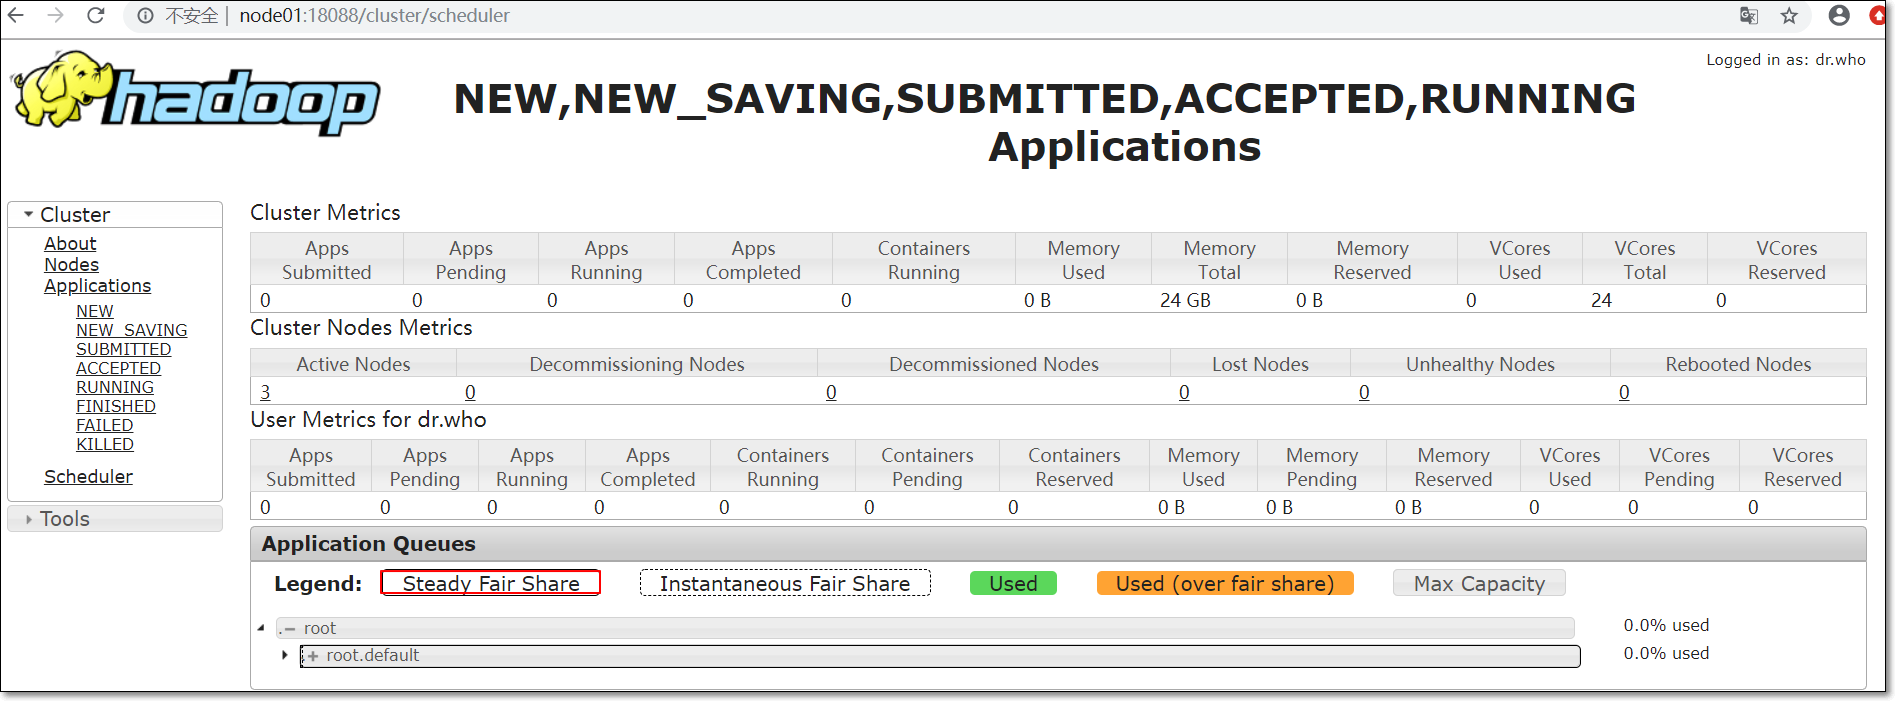
- 观察yarn web界面;使用的是fair scheduler
-
若CDH版本hadoop,要使用capacity scheduler,需要修改yarn-site.xml文件;node01上修改如下属性
<property> <name>yarn.resourcemanager.scheduler.class</name> <value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler</value> </property> -
并分发到各节点
[hadoop@node01 hadoop]$ pwd /kkb/install/hadoop-2.6.0-cdh5.14.2/etc/hadoop [hadoop@node01 hadoop]$ scp yarn-site.xml node02:$PWD [hadoop@node01 hadoop]$ scp yarn-site.xml node03:$PWD -
重启yarn
[hadoop@node01 hadoop]$ stop-yarn.sh [hadoop@node01 hadoop]$ start-yarn.sh -
而对于Capacity调度器,有一个专门的队列用来运行小任务,但是为小任务专门设置一个队列会预先占用一定的集群资源,这就导致大任务的执行时间会落后于使用FIFO调度器时的时间
-
如何配置容量调度器
-
队列层级结构如下
root ├── prod └── dev ├── spark └── hdp -
主节点上,将$HADOOP_HOME/etc/hadoop/中的对应capacity-scheduler.xml配置文件备份到其它目录
-
目录$HADOOP_HOME/etc/hadoop/中建立一个新的capacity-scheduler.xml;内容如下
<?xml version="1.0" encoding="utf-8"?> <configuration> <property> <name>yarn.scheduler.capacity.root.queues</name> <value>prod,dev</value> </property> <property> <name>yarn.scheduler.capacity.root.dev.queues</name> <value>hdp,spark</value> </property> <property> <name>yarn.scheduler.capacity.root.prod.capacity</name> <value>40</value> </property> <property> <name>yarn.scheduler.capacity.root.dev.capacity</name> <value>60</value> </property> <property> <name>yarn.scheduler.capacity.root.dev.maximum-capacity</name> <value>75</value> </property> <property> <name>yarn.scheduler.capacity.root.dev.hdp.capacity</name> <value>50</value> </property> <property> <name>yarn.scheduler.capacity.root.dev.spark.capacity</name> <value>50</value> </property> </configuration> -
将此xml文件,远程拷贝到相同目录下
-
将应用放置在哪个队列中,取决于应用本身。
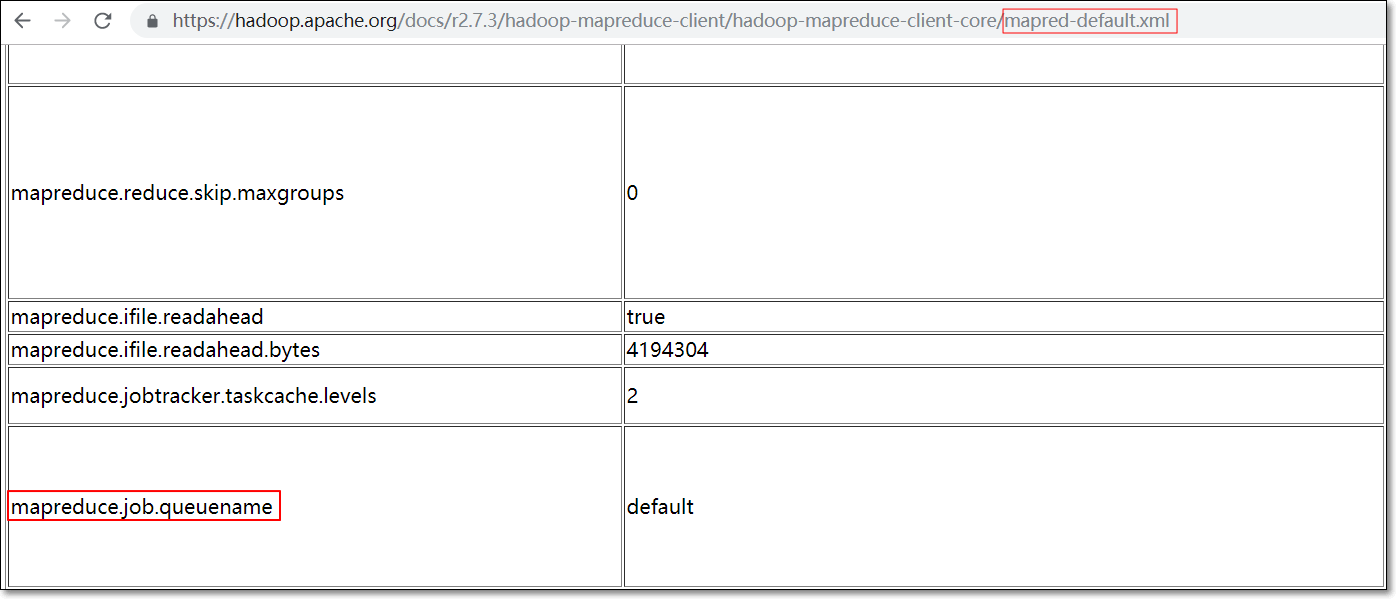
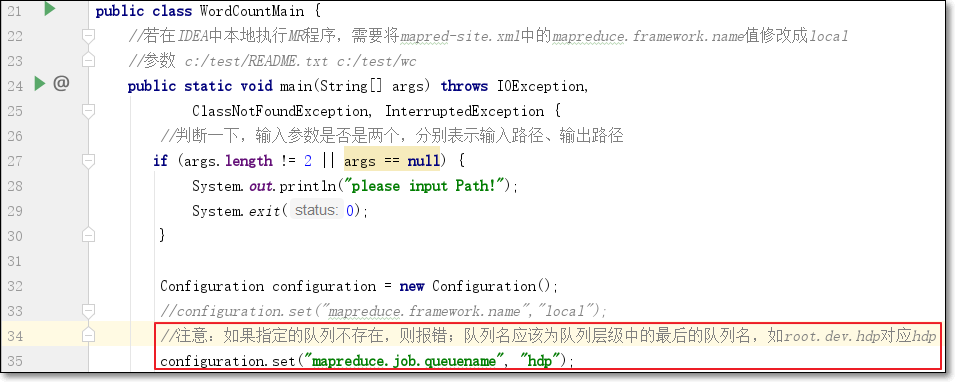
- 例如MR,可以通过设置属性mapreduce.job.queuename指定相应队列。以WordCount为例,如下
-
如果指定的队列不存在,则发生错误。
- 如果不指定,默认使用"default"队列,如下图
-
- 动态更新配置:容量调度器的配置在运行时,可以随时重新加载
- 调整资源分配参数;你需要编辑conf/capacity-scheduler.xml 并在yarn主节点运行命令让配置文件生效
- 另外,除非重启resourcemanager,否则队列只能添加不能删除;
- 但允许关闭
[hadoop@node01 hadoop]$ yarn rmadmin -refreshQueues
- 程序打包,提交集群运行
[hadoop@node01 target]$ hadoop jar com.kaikeba.hadoop-1.0-SNAPSHOT.jar com.kaikeba.hadoop.wordcount.WordCountMain /README.txt /w24
